
모바일 디바이스에 효율적인 비전 언어 모델 배포하기
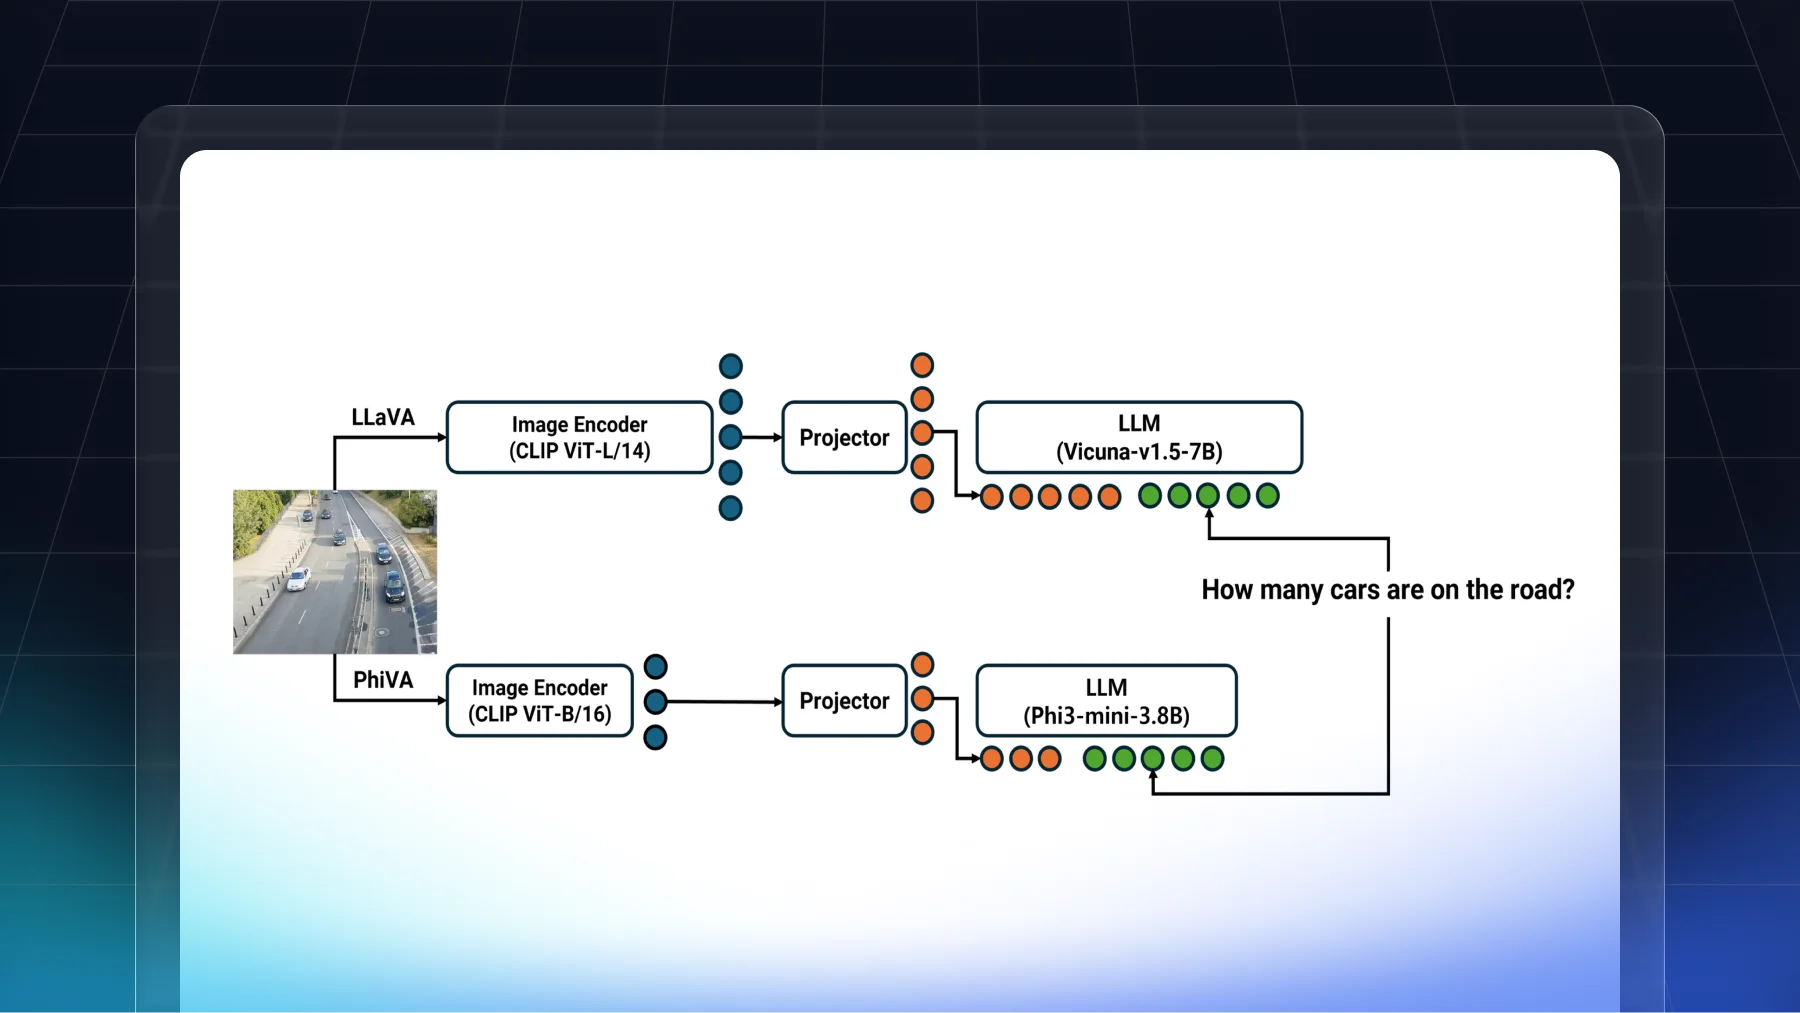
LLaVA를 Phi-3-mini와 CLIP ViT-B/16 기반 PhiVA로 경량화해 모바일 배포 과정을 설명했습니다. Galaxy 24 Ultra에서 이미지 인코딩 지연 시간을 37초에서 6초로 줄이고 디코딩 속도를 높였습니다.
#VLM#LLaVA
000
LLaVA를 Phi-3-mini와 CLIP ViT-B/16 기반 PhiVA로 경량화해 모바일 배포 과정을 설명했습니다. Galaxy 24 Ultra에서 이미지 인코딩 지연 시간을 37초에서 6초로 줄이고 디코딩 속도를 높였습니다.


생성형 VLM과 멀티턴 이미지 대화 데이터를 구축해 포토챗의 문맥 이해를 개선했습니다. 언어 모델 고정과 이미지-캡션 사전학습으로 리트리벌 모델보다 높은 성능을 확인했습니다.