


수식없이 GPT(트랜스포머) 이해하기. 2편
GPT 기반 LLM의 추론 최적화와 양자화 개념을 설명했습니다. DeepSeek의 Latent Vector 기반 방식으로 KV Cache 메모리를 줄이는 사례도 다뤘습니다.
#LLM#cache
8000
GPT 기반 LLM의 추론 최적화와 양자화 개념을 설명했습니다. DeepSeek의 Latent Vector 기반 방식으로 KV Cache 메모리를 줄이는 사례도 다뤘습니다.

딥러닝은 선형층과 비선형층을 여러 겹 쌓아 깊은 구조를 만드는 개념을 설명했습니다. 선형층만으로는 한계가 있어 활성화 함수를 넣는 이유를 쉽게 풀어주었습니다.

GPT의 핵심 구조인 트랜스포머 디코더와 Self Attention 흐름을 수식 없이 설명했습니다. 입력 벡터화부터 다음 단어 예측까지의 과정을 단계별로 정리했습니다.

추론 모델 학습용 데이터 레시피를 실험 중심으로 정리한 글입니다. 어려운 질문 선별, 다중 답변 생성, 데이터 확장이 성능 향상에 중요하다고 설명했습니다.

GPT를 다음 단어를 예측하는 모델로 쉽게 풀어 설명했습니다. Transformer 디코더만 사용하는 구조와 LLaMA 예시를 통해 Base Model 개념을 소개했습니다.

Qwen3의 Hybrid Thinking mode를 소개하고, 추론 On/Off를 제어하는 두 가지 방식을 설명했습니다. `/think`·`/no_think`와 `enable_thinking`의 동작 차이도 정리했습니다.


Hugging Face Transformer 모델을 AWS Inferentia/Trainium에 포팅하는 과정을 검증했습니다. return_dict=False 설정으로 tracing 오류를 줄여 12개 모델 모두 배포 가능함을 확인했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
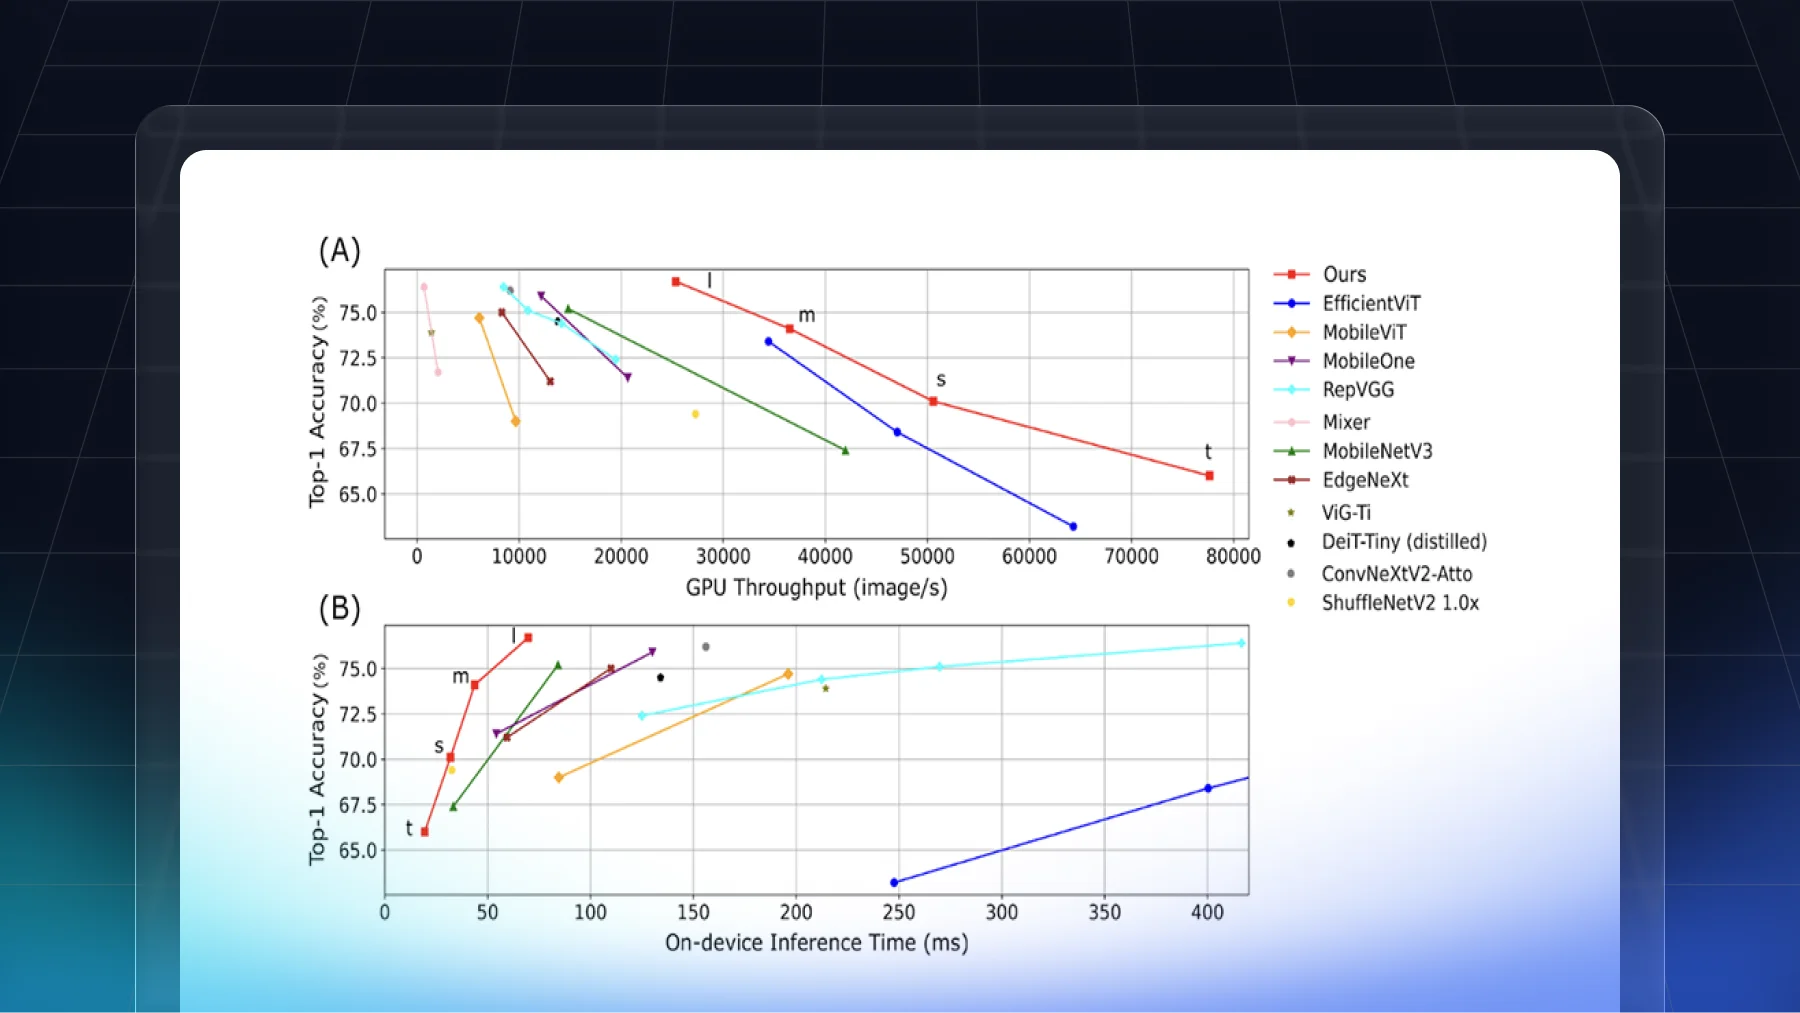
UniForm은 공유 어텐션 행렬로 다중 헤드 어텐션의 중복 계산과 메모리 사용량을 줄였습니다. 엣지 환경에서 정확도와 빠른 추론 속도를 함께 달성한 결과를 소개합니다.

안드로이드에서 DistilKoBERT 기반 스팸 분류 모델을 온디바이스 AI로 구현한 과정을 정리했습니다. TFLite 변환과 양자화로 모델 크기와 추론 속도를 개선하고 단말 벤치마크 결과도 확인했습니다.
딥시크와 마누스의 등장으로 중국 오픈소스 LLM 생태계가 빠르게 다원화되고 있음을 정리했습니다. 딥시크는 고성능 개방형 LLM, 마누스는 자율 에이전트라는 서로 다른 방향을 보여주었습니다.

데이터와 AI의 발전을 두 번의 대전환으로 정리하며, 빅데이터의 양적 성장과 AI 결합의 흐름을 설명했습니다. 데이터 품질, 실시간 처리, 거버넌스의 중요성도 함께 짚었습니다.

LLM 파인튜닝에서 배치 크기, 시퀀스 길이, 메모리 최적화 기법의 영향을 실험 기반으로 정리했습니다. GPU 제약과 데이터 특성에 맞춰 직접 실험하며 최적값을 찾는 접근을 강조했습니다.

AI가 채팅창을 넘어 로봇의 인지, 판단, 행동을 담당하는 흐름을 정리했습니다. 휴머노이드와 로봇 파운데이션 모델의 최신 사례도 함께 소개했습니다.