

카페 아르바이트를 뽑는데, AI 대학원생이 지원을 했다.
MoE Gemma 4 26B의 전문가 절반을 가지치기해 노트북 내장 GPU에서 카페 주문 처리를 검증했습니다. 일반 지식은 감소했지만 64e는 실전 성능을 유지했으며, 과도한 가지치기는 사람 평가에서 드러났습니다.
#LLM#MoE
10600
MoE Gemma 4 26B의 전문가 절반을 가지치기해 노트북 내장 GPU에서 카페 주문 처리를 검증했습니다. 일반 지식은 감소했지만 64e는 실전 성능을 유지했으며, 과도한 가지치기는 사람 평가에서 드러났습니다.
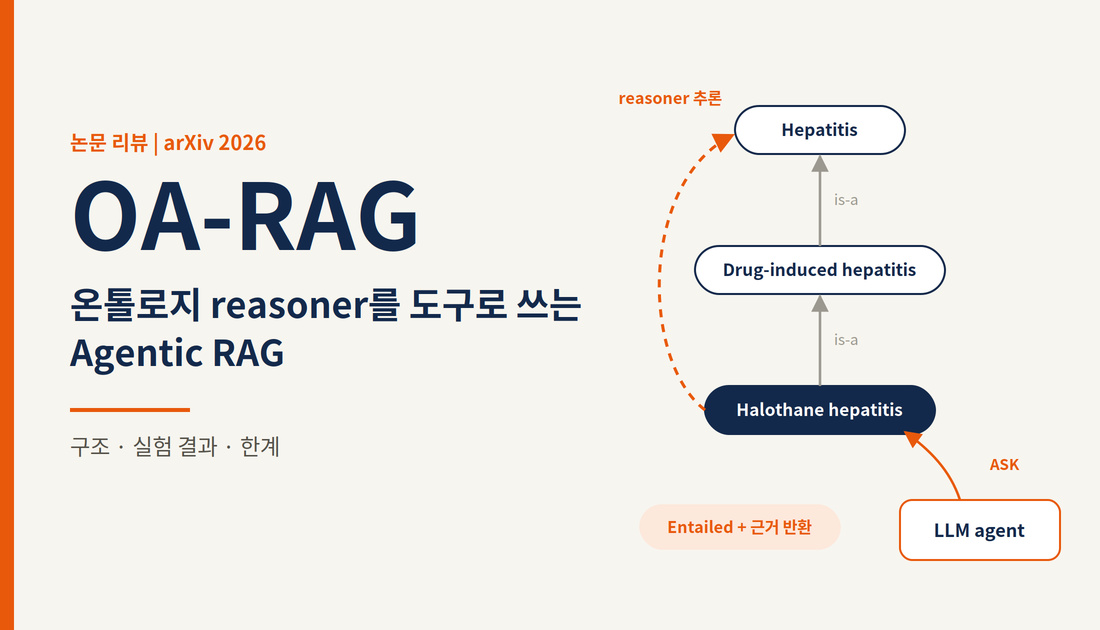
OA-RAG의 온톨로지 reasoner·LLM 결합 구조와 실험 결과를 분석했습니다. 의료 QA의 효율성과 평가 편향, grounding 신뢰도 한계를 함께 짚었습니다.
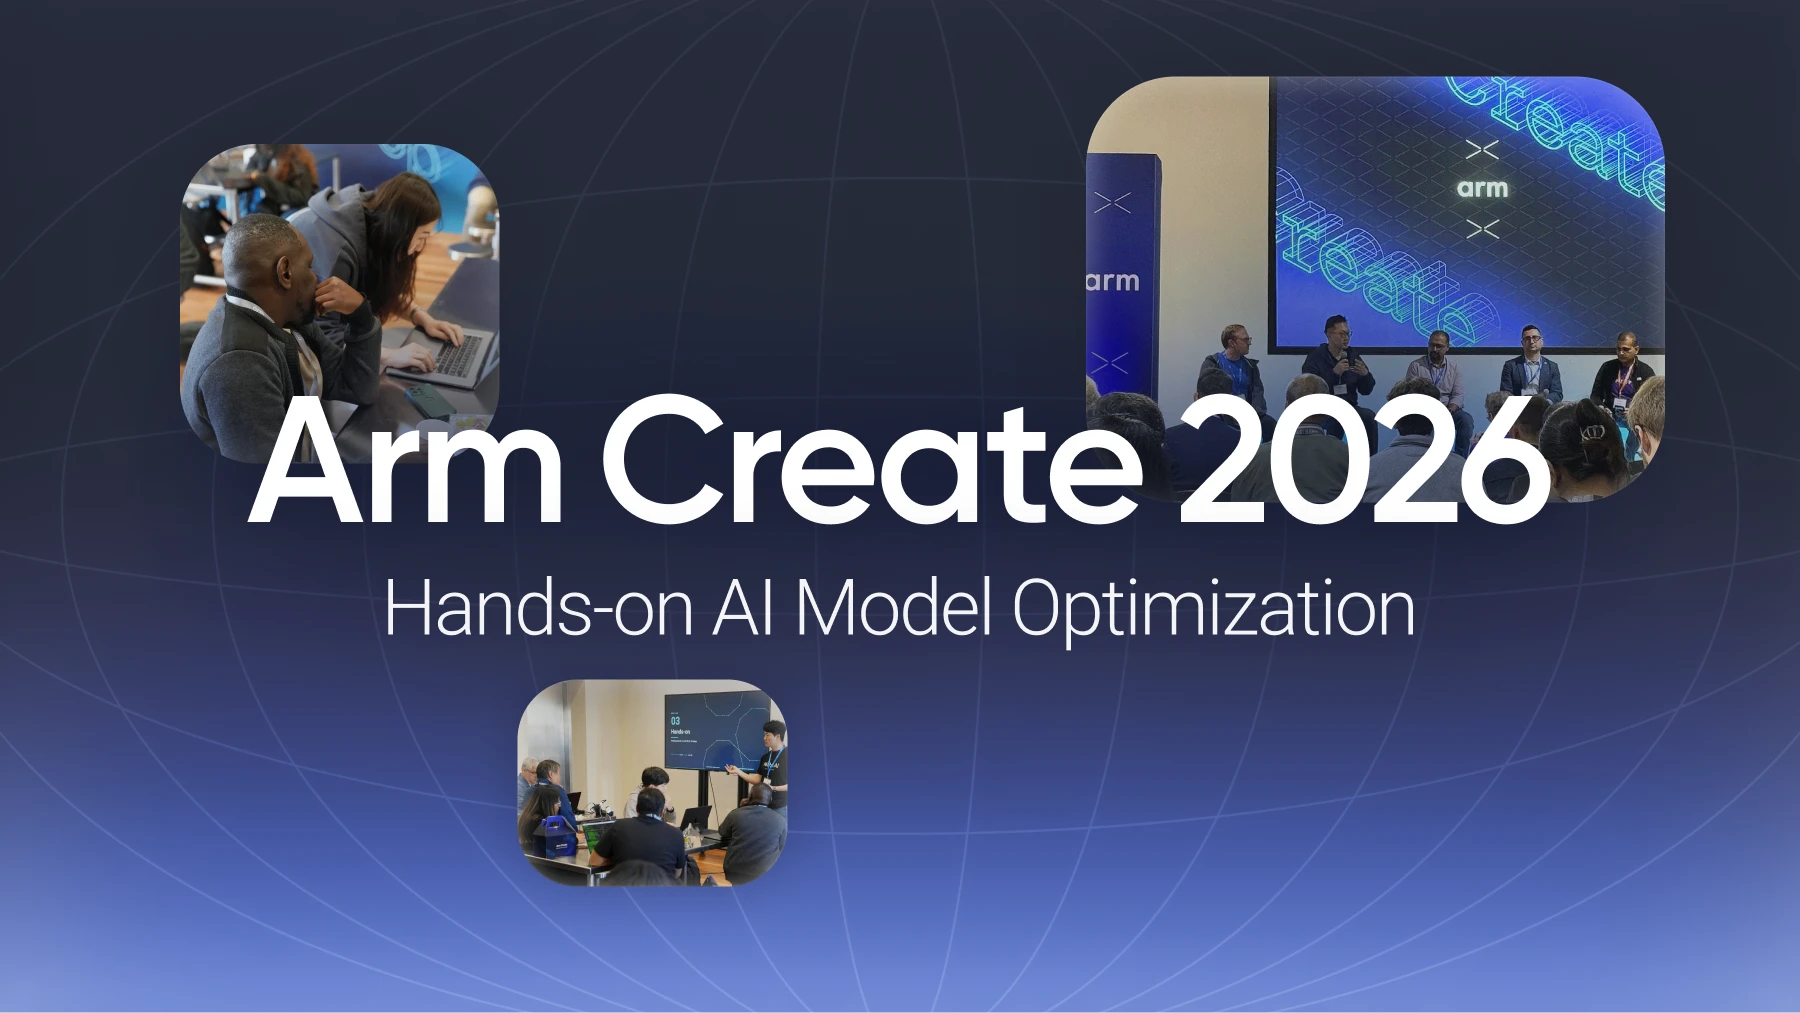
Arm AI Model Optimizer로 엣지 NPU와 클라우드 CPU용 모델 최적화 핸즈온을 소개했습니다. 양자화와 그래프 최적화로 지연 시간·모델 크기를 줄이고 정확도를 유지한 결과를 공유했습니다.
DEF CON CTF 본선에서 AI와 자동화 도구를 연결한 공격·방어 운영 경험을 공유했습니다. FUSE 취약점 체인과 PCAP 재현 기반 패치 검증 방식을 설명합니다.

LLM 호출마다 대화 맥락과 Tool 실행 상태를 반영해 모델을 선택하는 라우팅을 설계했습니다. Elevate-only 정책으로 캐시 손실을 줄이며 비용과 토큰 사용량을 절감했습니다.
확산형 언어모델의 병렬 토큰 예측·반복 정제 방식과 블록 생성, 토큰 편집을 설명했습니다. 도입 시 TPS뿐 아니라 첫 응답 지연, 품질, 비용을 같은 조건에서 비교해야 합니다.
병원 생성형 AI 활용 시 필요한 개인정보·의료 규제 점검 항목을 정리했습니다. 입출력 검사와 기록 관리로 AI 보안을 강화하는 SecureBridge를 소개합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

커머스API 플랫폼에서 AI로 라우팅 룰 검수, 기술지원, 도구 호출을 연결한 사례를 소개합니다. MCP 게이트웨이와 지식 자산화를 통한 API 운영 확장 과정을 다룹니다.
간접 프롬프트 인젝션으로 AI 에이전트가 DB 시크릿을 조회·유출할 수 있는 흐름을 재현했습니다. 프롬프트 의존 대신 최소 권한과 외부 출력 검사가 필요합니다.
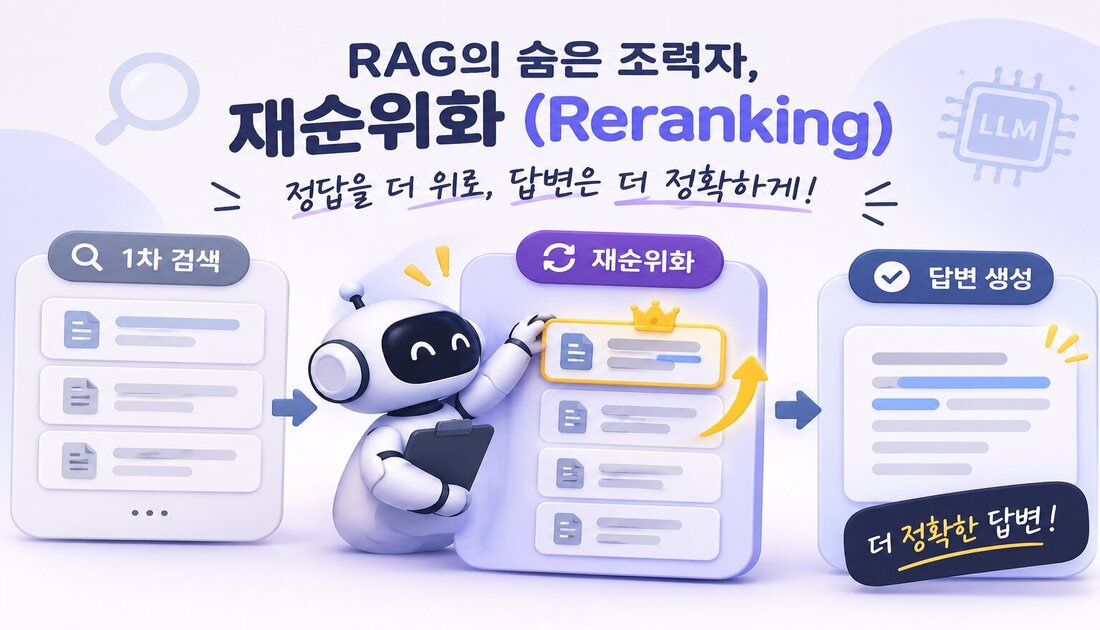
RAG 재순위화의 구조와 기술 발전, 운영 설정, 모델 선정 기준을 정리했습니다. 한국어 기업 문서 실험으로 정확도·속도·GPU 비용의 차이를 비교했습니다.

에이전트 메모리를 원본 기록과 대조해 정제하는 Anthropic의 꿈꾸기 개념을 정리했습니다. Claude Code 메모리를 작게 유지하고 주기적으로 검토·정리하는 방법을 제안합니다.
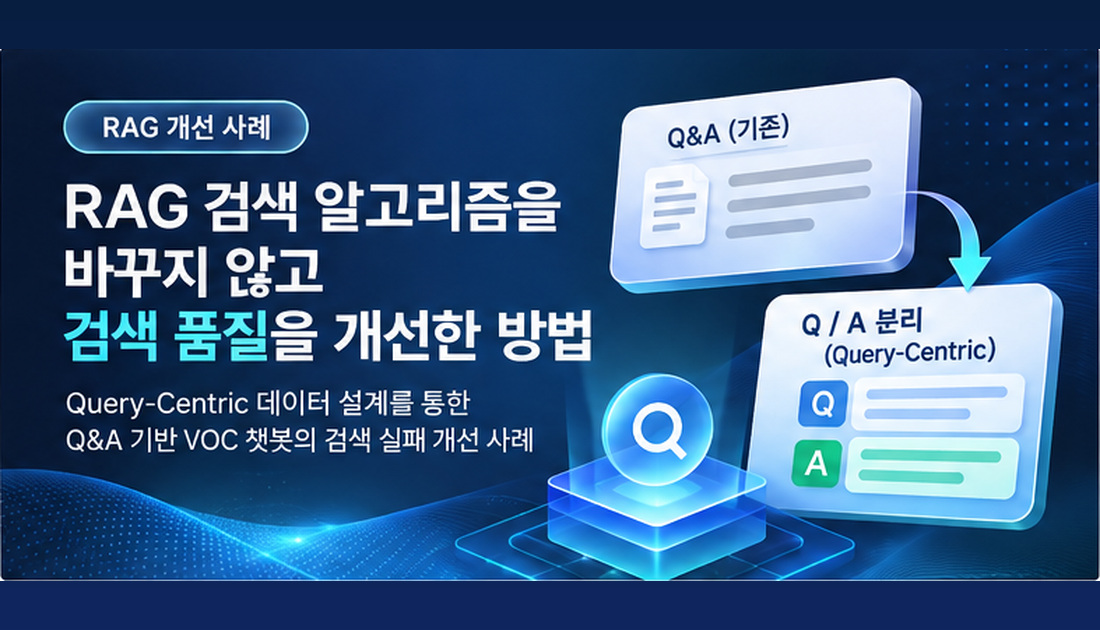
RAG 알고리즘을 유지한 채 질의 중심 인덱스와 답변 DB 분리로 Q&A 검색 노이즈를 줄였습니다. BM25·KNN·RRF의 후보 품질과 운영 검증 기준을 설명합니다.
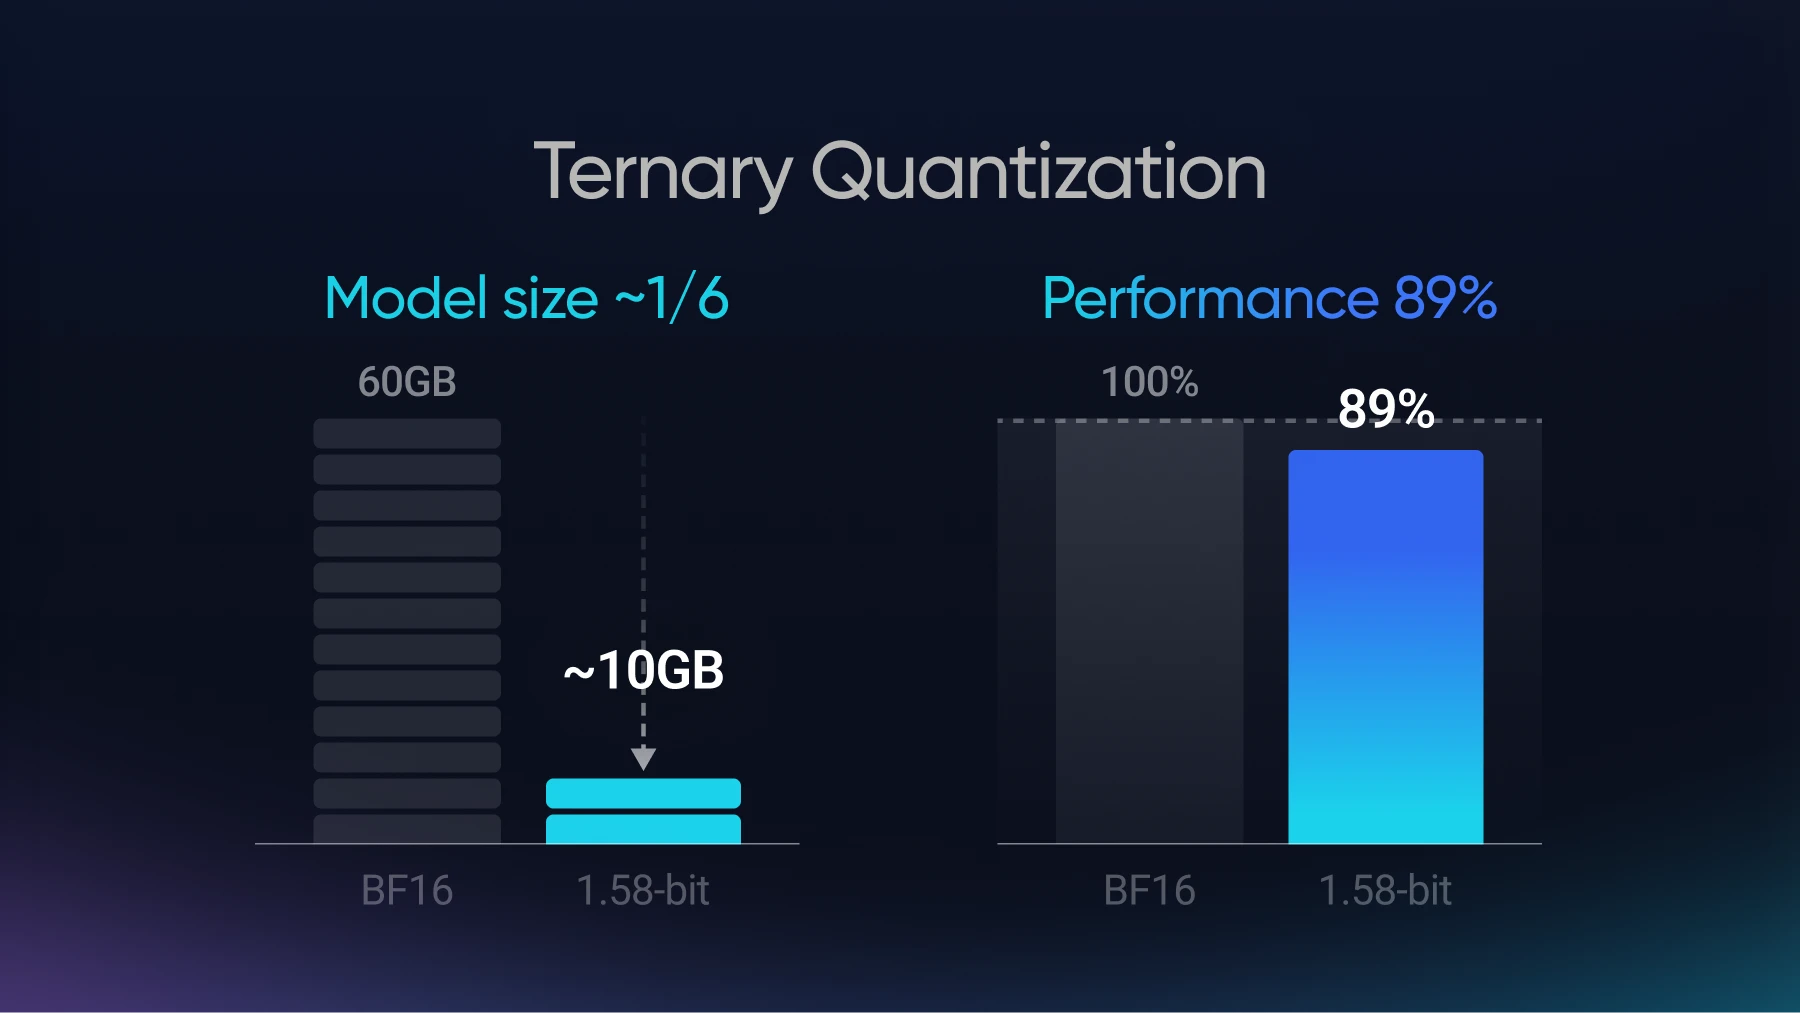
1.58비트 터너리 양자화로 30B LLM 가중치를 약 10GB까지 줄였습니다. 증류와 경계 마스킹으로 성능을 복원해 24GB 이상 맥북 실행 가능성을 제시합니다.
망분리 환경에서 적용 범위를 제한하고 n8n 중심의 사내 AX 환경을 구축했습니다. 재무·CR팀 반복 업무를 자동화해 시간 절감과 즉시 대응 체계를 만들었습니다.