
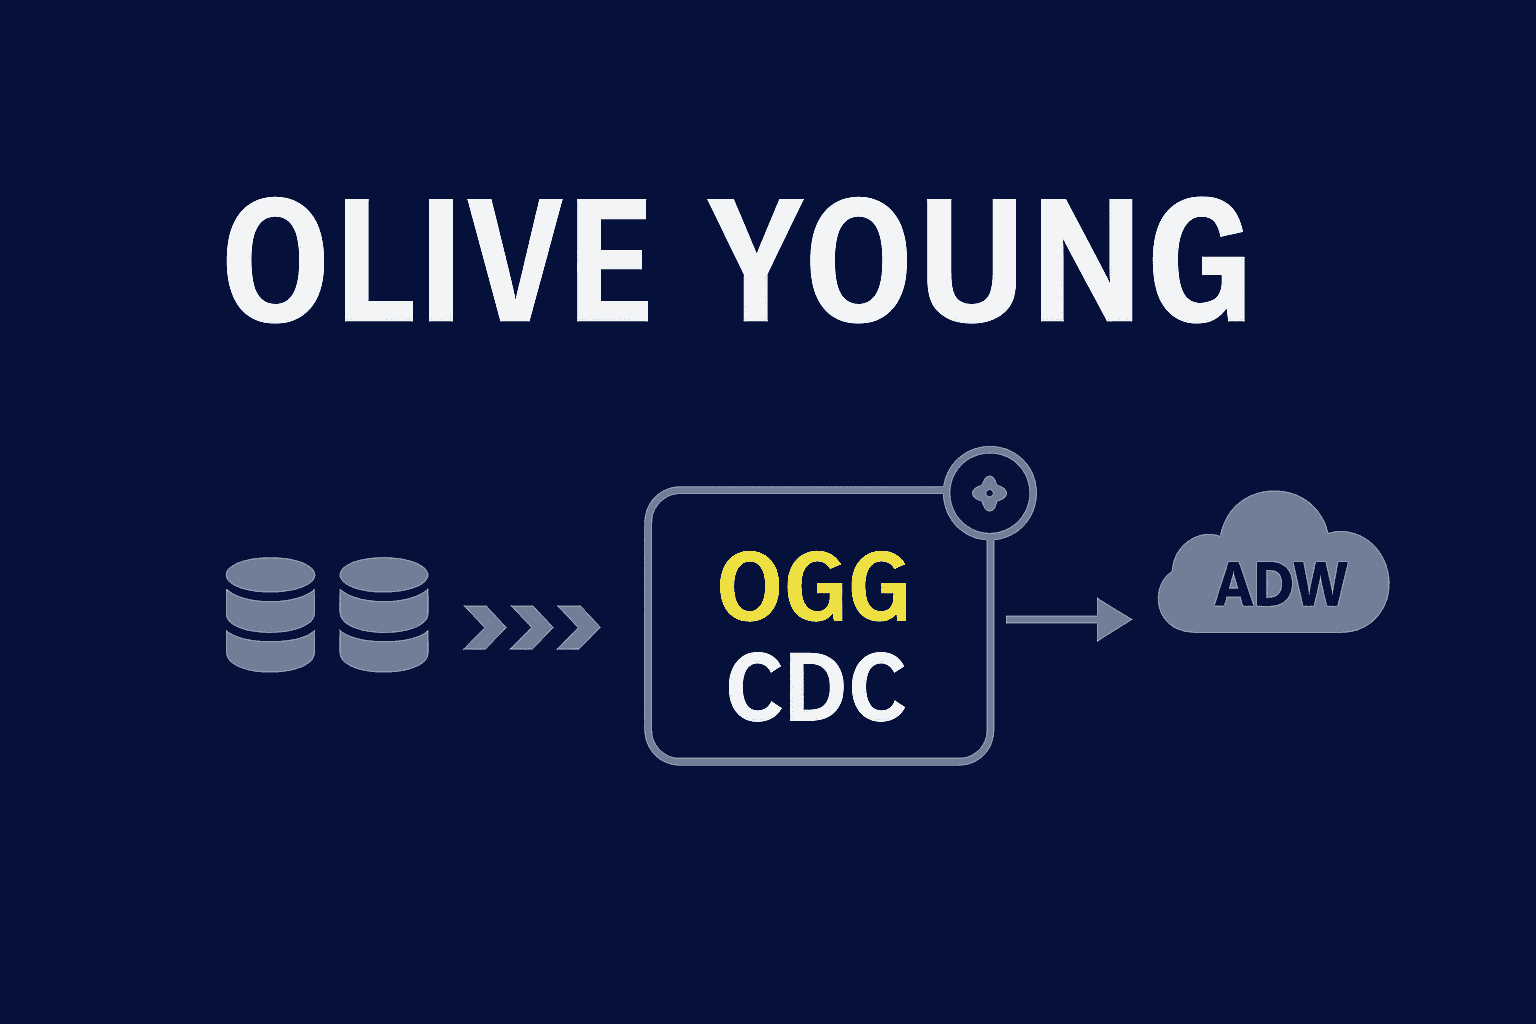

올리브영의 실시간 캠페인 타겟팅을 위한 CDC 전환기
ODI 배치 기반 캠페인 동기화를 OGG와 Kafka 기반 CDC로 전환한 사례를 다뤘습니다. 메시지 순서 문제는 Retry, DLT, 복구 배치로 보완했고 실시간 정합성과 운영 모니터링을 강화했습니다.
#CDC#Kafka
12200
ODI 배치 기반 캠페인 동기화를 OGG와 Kafka 기반 CDC로 전환한 사례를 다뤘습니다. 메시지 순서 문제는 Retry, DLT, 복구 배치로 보완했고 실시간 정합성과 운영 모니터링을 강화했습니다.
Karrot가 MongoDB 적재 방식의 한계를 해결하기 위해 CDC를 도입한 과정을 공유했습니다. 변경 로그 기반으로 BigQuery 적재를 구성하되, 초기 스냅샷은 별도 도구 활용을 검토했습니다.
MongoDB 덤프의 DB 부하와 SLO 문제를 해결하기 위해 CDC를 도입했습니다. Flink CDC와 Spark, 이중 테이블 구조로 적재와 스키마 변경, 정합성 검증을 묶었습니다.

네이버페이 주문의 DB CDC 복제 도구를 ergate로 전환한 경험을 공유했습니다. Flink와 Spring으로 복제, 검증, 복구를 분리해 성능과 운영 편의성을 개선했습니다.
Kafka 소비 결과를 Parquet으로 변환해 S3에 적재하는 실시간 수집 파이프라인을 설계하고 구축했습니다. 또한 Flush, 커밋, 모니터링 체계를 통해 누락 없이 안정적으로 운영하는 방법을 정리했습니다.
게이미피케이션 확장에 맞춰 Kafka CDC와 Argo Workflow 기반의 데이터·랭킹 파이프라인을 구축했습니다. 모니터링과 Feature Flag로 대규모 트래픽 운영 및 제한적 기능 실험을 지원합니다.


리멤버앤컴퍼니가 Aurora MySQL의 분석 부하를 줄이기 위해 S3 Tables 기반 CDC 데이터 레이크를 구축한 과정을 다뤘습니다. 기존 데이터 이관, Debezium·MSK·Iceberg Kafka Connect 설정과 운영상 주의점을 정리했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
PostgreSQL 데이터를 Elasticsearch로 동기화하는 Kafka Connect CDC 파이프라인 구성 글입니다. 10년 넘게 운영한 레거시 시스템의 검색 연동 맥락을 소개합니다.
PostgreSQL에서 ES로의 CDC 파이프라인을 Kafka Connect로 구성한 뒤의 트러블슈팅 글입니다.

Iceberg CDC에서 발생하는 정합성 이슈와 원인을 정리하고, Position Delete 중심의 처리 원칙을 설명했습니다. Kafka key 설정, Commit Timeout, Schema Evolution 대응으로 중복 문제를 해결한 사례를 공유했습니다.

뮤직카우가 Amazon RDS와 Amazon Redshift를 Zero-ETL로 연결해 준실시간 CDC 파이프라인을 구축한 사례를 공유했습니다. DMS 대비 관리 부담과 비용을 줄이고 자동 복구까지 활용한 설정 방법과 주의사항을 정리했습니다.
DBT와 CDC, Airflow로 클라이언트 여정을 추적하는 `data_logs` 테이블 구축 사례를 소개했습니다.복잡한 조인과 스캔 비용을 줄이기 위해 증분 모델링과 파티션 최적화를 적용했습니다.
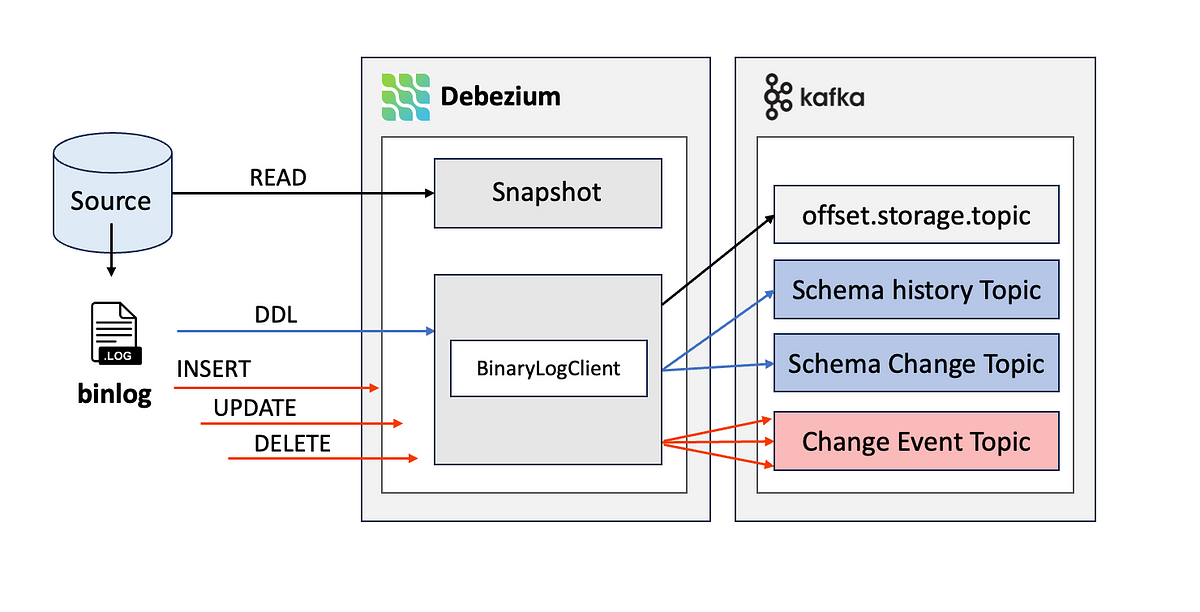

기존 배치 적재의 지연을 줄이기 위해 Debezium 기반 실시간 CDC 파이프라인을 구축한 과정을 정리했습니다. Kafka Connect 구조, 스냅샷, 오프셋 관리와 성능 개선 포인트까지 살펴보았습니다.

쿠폰 적용 가능 상품을 실시간으로 조회하기 위해 이벤트 기반 반정규화와 Elasticsearch 인덱싱 구조를 구축했습니다. 복잡한 매핑과 갱신 조건을 단순화하고 검색 성능과 운영성을 함께 개선했습니다.