AI
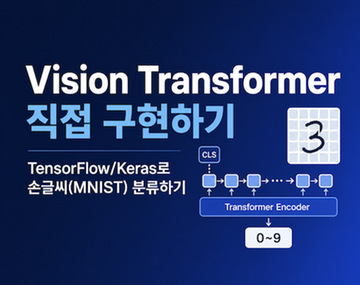
Vision Transformer 구현 — TensorFlow/Keras로 손글씨(MNIST) 분류하기
두줄요약
Vision Transformer를 TensorFlow/Keras로 구현해 MNIST 손글씨 분류 과정을 단계별로 설명했습니다. 데이터 전처리부터 패치화, 어텐션, 인코더, 분류까지 텐서 흐름과 구현 포인트를 정리했습니다.
핵심 내용
- Transformer를 이미지 분류에 적용한 Vision Transformer를 MNIST 손글씨 분류 예제로 단계별 구현
- 이미지 정규화, 패치화, 패치 임베딩, CLS 토큰, 위치 임베딩, Multi-Head Self-Attention, Encoder 블록, 풀링, 분류 헤드 흐름 정리
- TensorFlow/Keras 기준으로 텐서 모양 변화와 핵심 연산을 함께 설명
- x_test 전처리 누락, LayerNormalization 재사용, CLS 토큰 설계 차이 등 구현상의 수정 포인트 포함