
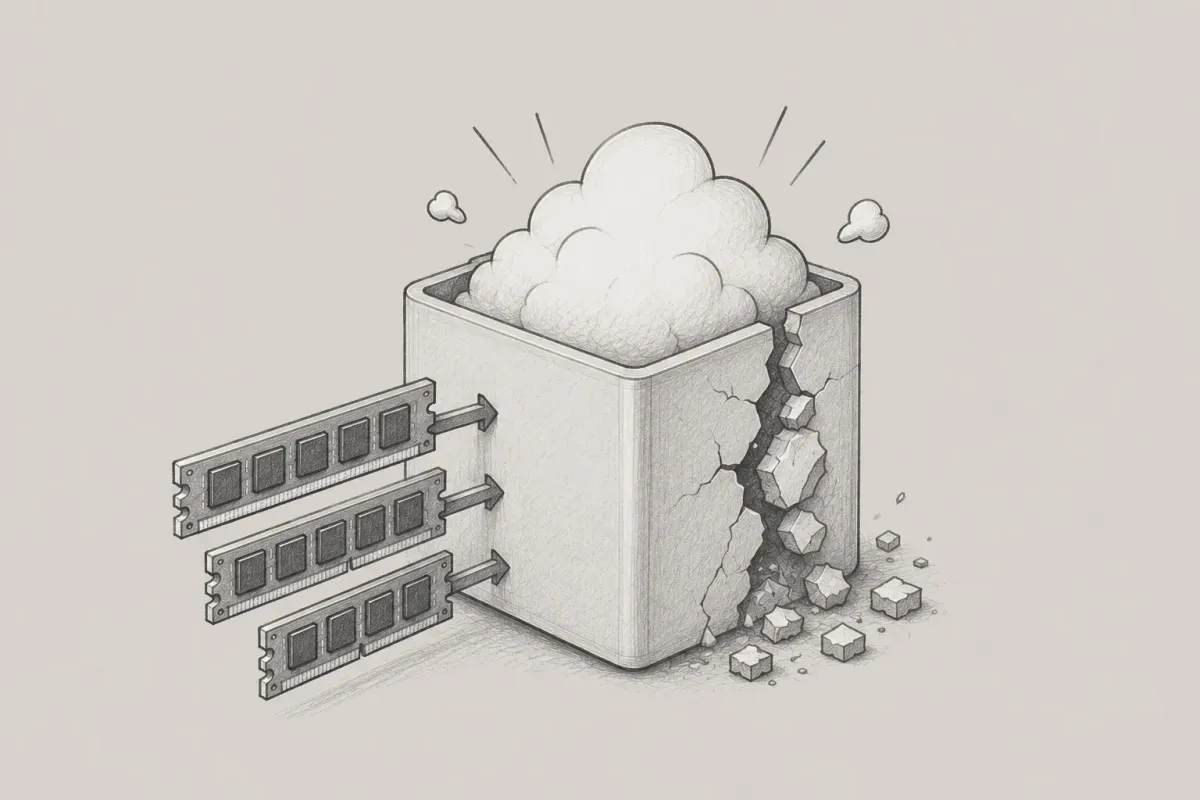
JVM Heap 설정과 OOMKilled
Kubernetes Pod의 OOMKilled 원인을 Memory Limit만으로 보지 않고 JVM Heap 설정까지 함께 점검했습니다. MaxRAMPercentage를 낮추자 Full GC가 정상 동작하며 재시작 문제가 해소됐습니다.
#Kubernetes#Java
6300

Kubernetes Pod의 OOMKilled 원인을 Memory Limit만으로 보지 않고 JVM Heap 설정까지 함께 점검했습니다. MaxRAMPercentage를 낮추자 Full GC가 정상 동작하며 재시작 문제가 해소됐습니다.
Istio Ambient mode 업그레이드를 istiod, istio-cni, ztunnel로 나눠 안전하게 진행하는 순서를 정리했습니다. 특히 ztunnel은 rolling update보다 node pool blue-green 방식이 더 안전하다고 설명했습니다.
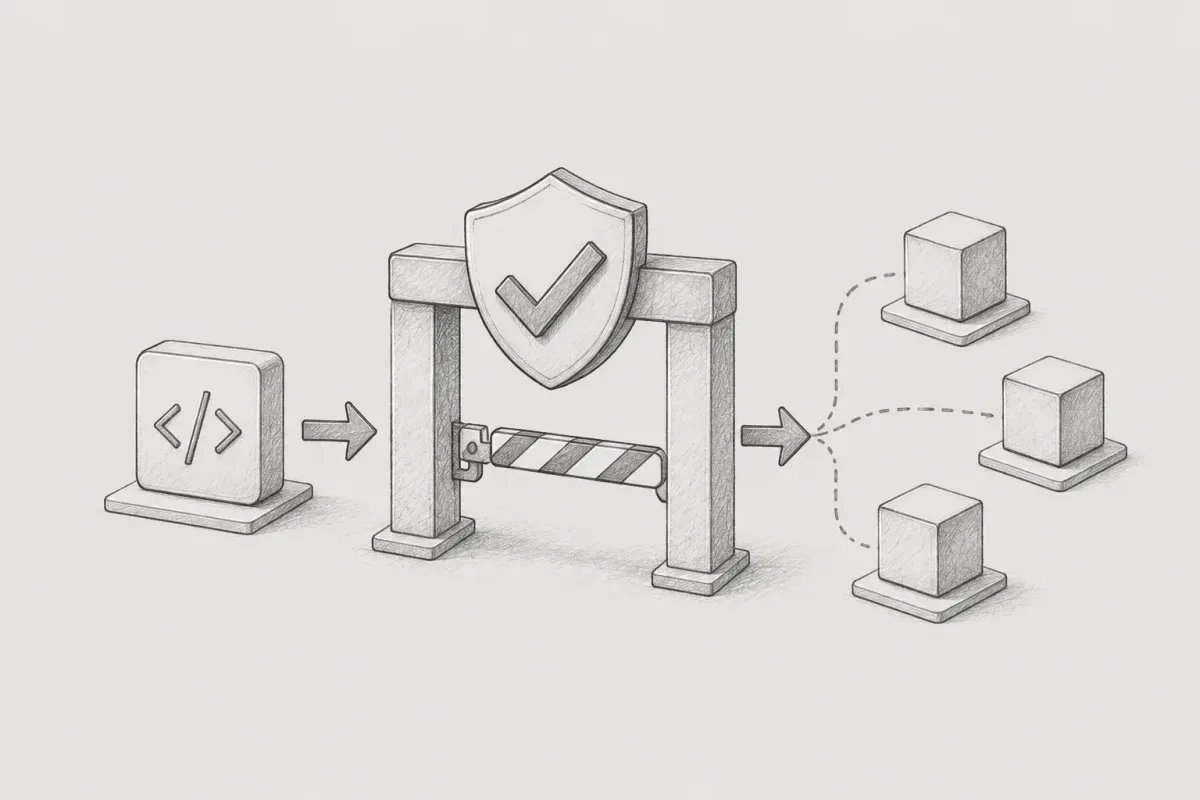
MSA 품질관리를 CI 게이트로 옮겨 일관된 기준으로 강제하는 방법을 정리했습니다. 변경 범위 검증, 차단 강도 분리, immutable artifact 승격을 통해 운영 신뢰성을 높였습니다.

terraform plan만으로는 인프라의 실제 동작을 확인할 수 없다는 문제를 다뤘습니다. 로컬 클러스터 검증과 재현 가능한 선언으로 apply 전 신뢰도를 높이는 방법을 소개했습니다.
Ambient mode에서 Pod은 Ready인데 mesh 트래픽이 실패하는 partially enrolled 문제를 다뤘습니다. istio-cni 준비 전에는 일반 Pod이 스케줄되지 않도록 startup taint와 untaint-controller를 활용했습니다.
공유 dev 병목을 없애기 위해 브랜치 하나로 격리 환경을 만드는 Environment Variant 설계를 소개했습니다. ArgoCD ApplicationSet으로 생성과 회수를 자동화해 환경 생명주기를 git과 연결했습니다.
AI 연구용 GPU가 부족하고 활용률도 낮아 효율적 운영이 필요했습니다. 데스크톱 가상화로 연구 규모에 맞게 나누고 자동 회수해 공정성을 높였습니다.

상품 모니터링 체계를 Slack 알림 중심에서 DLQ 재처리, Workflow 자동 분석, 정합성 자동화로 진화시켰습니다. 사람이 개입할 일을 줄이고 장애 판단과 대응 속도를 높인 사례를 공유했습니다.
SSL/TLS 인증서 유효기간이 계속 단축되는 흐름과 그에 따른 운영 리스크를 정리했습니다. 자동화와 모니터링을 중심으로 한 대응 전략도 함께 제시했습니다.
NAVER API HUB 출시와 함께 API 종량제·모니터링 기능 및 20만 원 크레딧 프로모션을 소개했습니다. Claude Code용 NCP MCP로 클라우드 리소스 생성·조회도 지원합니다.
세 플랫폼에 흩어진 배포 이력을 APM 트레이스 기반 신호로 통합했습니다. 장애 스레드에 직전 배포를 자동 첨부해 대응 속도를 높였습니다.
플랫폼팀이 코드 바깥의 환경 실체를 선언으로 만드는 방식을 설명했습니다. Kafka 토픽 선언과 검증, 추적 가능한 거버넌스 사례를 다뤘습니다.
Alert 생성과 전달, 대응 흐름을 IaC와 표준화된 Slack 메시지로 정리한 개선 과정을 소개했습니다. 반복 Alert 재사용, grouped Alert, AI 연동, 모니터링 자체 감시까지 운영 개선을 다뤘습니다.


AWS DevOps Agent로 성능 테스트 분석을 자동화하는 활용 사례를 소개했습니다. JMeter 부하 테스트에서 병목 원인을 찾고 수정 후 재검증하는 흐름을 보여주었습니다.