

Beauty Domain-Specific Pre-trained Language Model 개발하기
뷰티 리뷰·제품 정보와 공개 데이터를 학습한 도메인 특화 ELECTRA 기반 PLM 개발 과정을 소개했습니다. 리뷰 분류 성능을 높이고 검수 자동화와 제품 속성 추출에 적용했습니다.
#BERT#NLP
000

뷰티 리뷰·제품 정보와 공개 데이터를 학습한 도메인 특화 ELECTRA 기반 PLM 개발 과정을 소개했습니다. 리뷰 분류 성능을 높이고 검수 자동화와 제품 속성 추출에 적용했습니다.
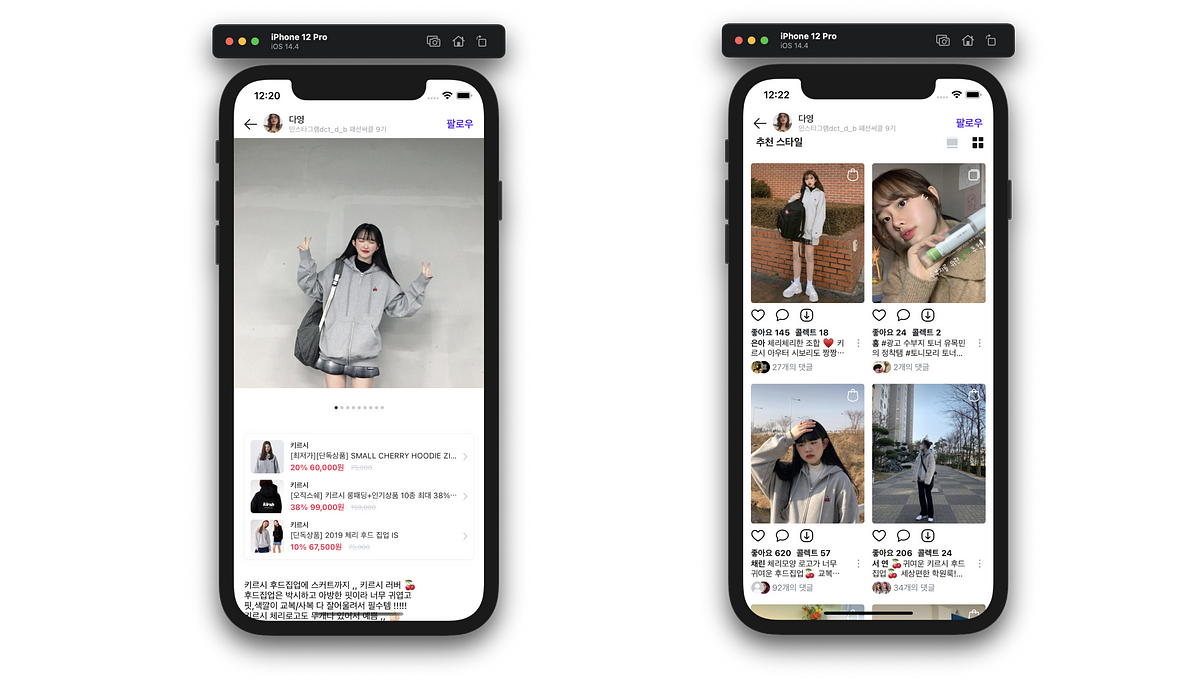
사용자 행동 데이터를 Matrix Factorization과 ALS로 분석해 연관 스타일 추천을 개선했습니다. A/B 테스트에서 방문과 전환, 구매전환율 상승으로 관심사 기반 추천의 효과를 확인했습니다.

Knowledge Tracing의 역할과 기존 단일 개념 문항 모델의 한계를 설명했습니다. 복수 개념을 반영하는 KTM의 구성과 성능 특성을 소개합니다.
Scaling, Standardization, Regularization의 정의와 목적, 대표 기법을 구분해 정리했습니다. Min-Max·Z-Score·Ridge·Lasso의 특성과 용어 혼용 시 주의점을 설명합니다.
줌인터넷과 연합뉴스가 AI 기반 뉴스 3줄 요약 서비스를 공동 개발했습니다. 추출식 요약 모델과 자체 태깅 툴로 학습 데이터를 구축해 실시간 API로 운영했습니다.
실시간 이상탐지 모델의 안정성을 위해 입력 데이터 검증 방법을 소개했습니다. JSON Schema, feature 순서 정렬, t-test 기반 Dataset Shift 탐지를 다뤘습니다.
YOLOv1의 단일 신경망 기반 객체 검출 구조와 출력·손실 구성을 설명했습니다. YOLOv2의 앵커 박스, 다중 스케일 학습 등 정확도 개선 기법을 정리했습니다.
베이지안 최적화를 활용해 알고리즘 트레이딩의 하이퍼파라미터를 효율적으로 찾는 방법을 설명했습니다. 백테스팅 실험에서는 베이지안 mean-variance 모델이 높은 누적 수익률과 낮은 변동성을 보였습니다.
Ubuntu 20.04 CLI 서버에서 CUDA 11.1 기반 GPU 가속 환경 구성을 정리했습니다. 드라이버·CUDA·cuDNN·딥러닝 프레임워크의 호환성과 검증 방법을 안내합니다.

의료 인공지능에서 예측 근거와 임상적 타당성을 함께 제공해야 하는 이유를 설명했습니다. VitalCare의 Attention·GNN 기반 해석 기능과 멀티모달 모델 발전 방향을 소개합니다.
게임 행동 로그를 Transformer-Autoencoder로 임베딩해 긴 시퀀스 처리와 GPU 학습 효율을 개선했습니다. 부정사용자 탐지에서 LSTM 기반 임베딩보다 높은 F1 Score를 확인했습니다.
시스템 로그를 Doc2Vec으로 벡터화해 사용자별 정상 행동 패턴과 변화를 분석했습니다. 개인·조직·직무 기준을 함께 활용해 오탐을 줄이는 위협 탐지 방향을 제안합니다.
뉴스 감정 정보와 과거 고용률 데이터를 결합해 고용률 현재 예보 모델을 개발한 과정을 소개했습니다. PCA, 데이터 증강, Transformer 적용으로 성능을 개선했으며 특수 사건 대응 과제도 함께 정리했습니다.
대용량 Docking 기반 가상탐색의 장점과 정확도·비용 한계를 분석했습니다. 능동학습과 상호작용 기반 점수화로 탐색 효율 개선 방향을 제시했습니다.