
내비 안내 음성은 어떻게 자동으로 만들어질까? - 16편 - 서버 기반 TTS 개발하기
내비 안내 음성은 어떻게 자동으로 만들어질까? - 16편 - 서버 기반 TTS 개발하기
서버 기반 TTS 개발 연재의 한 편으로, TTS의 기본 개념을 소개했습니다. 텍스트를 음성으로 바꾸는 기술의 의미를 간단히 설명했습니다.
#TTS#DB
4100

서버 기반 TTS 개발 연재의 한 편으로, TTS의 기본 개념을 소개했습니다. 텍스트를 음성으로 바꾸는 기술의 의미를 간단히 설명했습니다.
Kubernetes 기반 MLOps 환경에서 GPU 자원 운영 부담을 줄이기 위한 기반을 설계했습니다. Karpenter와 NVDP로 GPU 노드의 자동 생성·회수 흐름을 구성했습니다.

AI Art의 프롬프트 기반 생성 방식을 UI·UX 디자인 시스템에 적용할 가능성을 살펴봤습니다. 사용자 데이터로 광고 크리에이티브를 자동 최적화하는 방향도 제안했습니다.
AI 아트가 디자인과 광고 크리에이티브에 줄 수 있는 가능성을 살펴보는 글입니다. 프롬프트 기반 생성 도구와 그에 따른 기회, 한계, 위험을 함께 언급했습니다.
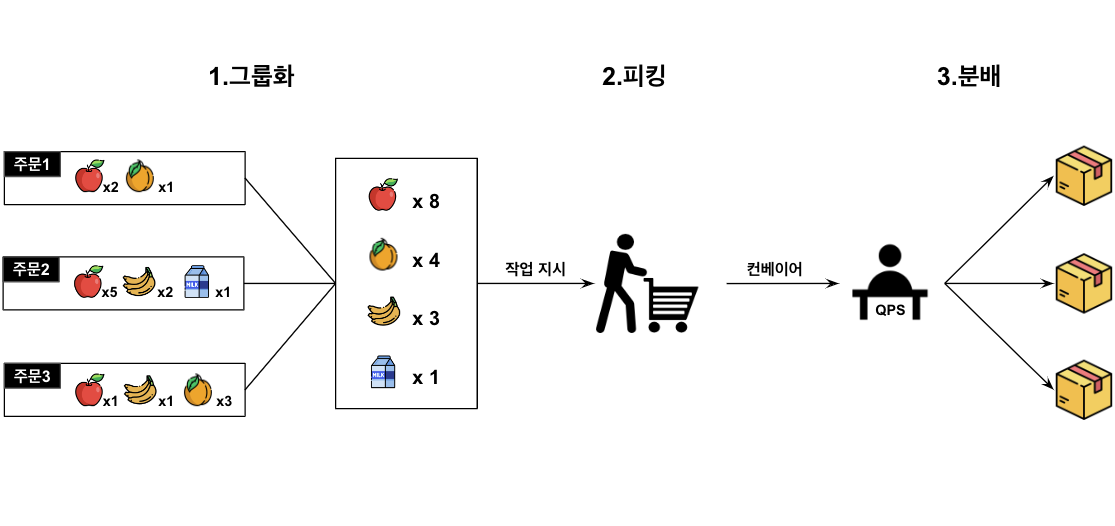
QPS 생산성을 바구니 처리 속도로 정의하고, 고유 상품 수 최소화 문제로 전환했습니다. 유전 알고리즘 적용으로 기존 방식보다 고유 상품 수를 약 10% 이상 줄였습니다.

TFX 커스텀 컴포넌트로 신규 데이터부터 학습·모델 등록까지의 파이프라인을 구성했습니다. Apache Beam과 사내 레지스트리를 연동하는 구현·운영 주의점을 설명합니다.
상위·하위 인텐트를 함께 추론하는 챗봇을 위해 MTL 기반 PLE 모델과 CurricularFace loss를 적용했습니다. 기존 앙상블보다 성능과 관리 효율을 함께 개선한 사례를 소개했습니다.

OpenAI VPT의 마인크래프트 다이아몬드 곡괭이 제작 학습 과정을 리뷰했습니다. 영상에서 추정한 행동 데이터와 사전학습·미세조정·강화학습의 결합을 설명합니다.

의료 데이터의 복잡성 때문에 AI 모델 개발과 재현성이 어려운 문제를 짚었습니다. Clairvoyance를 표준화된 파이프라인 도구로 소개하며 개발·평가·최적화의 체계화를 제안했습니다.

AWS Inferentia 기반 TensorFlow 모델 서빙의 정합성 검증과 EKS 배포 과정을 소개했습니다. 토크나이저 분리와 동적 배치로 처리량을 높이고 비용 절감 가능성을 확인했습니다.
카카오페이의 모델 서빙 최적화를 위해 프레임워크를 도입한 과정과 성능 개선 테스트 결과를 공유합니다. 효율적인 서빙을 위한 선정 기준과 최적화 관점을 함께 다룹니다.
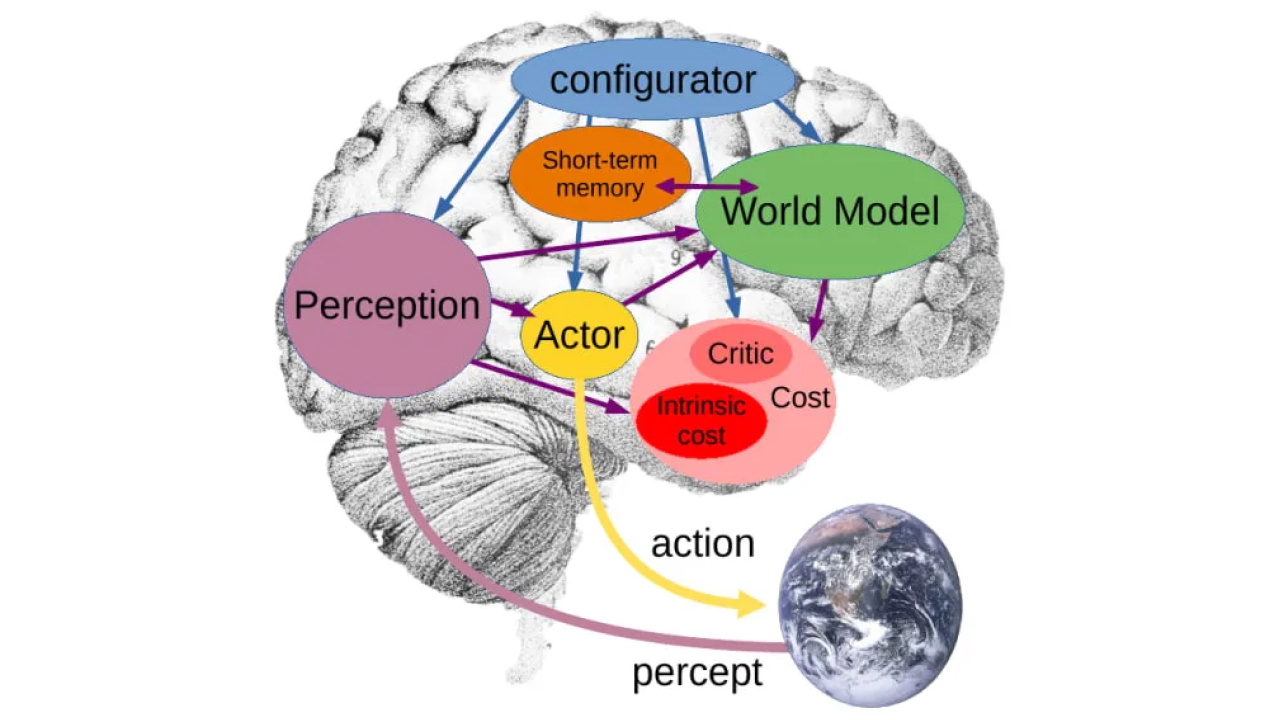
Dynamics Model을 제어와 시뮬레이션 문제에 활용하는 사례를 소개했습니다. 실제 데이터와 물리 모델을 결합해 sim-to-real gap을 줄이는 가능성을 설명했습니다.
자연어처리의 토픽 모델링을 개인화 추천에 적용하는 방식을 소개했습니다. 사용자 행동 데이터를 바탕으로 관심 주제를 추출해 맞춤형 추천을 구성하는 개념을 설명했습니다.

EHR 기반 의료 AI의 문제 정의부터 일반화 평가까지 5단계 개발 파이프라인을 소개했습니다. 보정·불확실성 추정과 임상 환경의 엄격한 검증 필요성을 강조했습니다.