
AWS MLOps 분산학습 워크숍 방문기
AWS MLOps 분산학습 워크숍에서 SageMaker 기반 MLOps와 분산학습 사례·실습을 경험했습니다. 데이터 드리프트 모니터링과 재학습 자동화 가능성도 살펴봤습니다.
#AWS#SageMaker
000

AWS MLOps 분산학습 워크숍에서 SageMaker 기반 MLOps와 분산학습 사례·실습을 경험했습니다. 데이터 드리프트 모니터링과 재학습 자동화 가능성도 살펴봤습니다.
수요예측·추천 모델을 현장에 배포하고 운영하는 구조와 MLOps 기반을 소개했습니다. 데이터 품질, 성능 해석, Leakage 방지와 협업 기반 사후 대응의 중요성을 정리했습니다.
데이터사이언스팀의 예측모델 개발·운영 구조와 MLOPS 기반 서빙 체계를 소개했습니다. 또한 배포 후 대응, 성능 분석, Leakage 주의 등 실무에서 배운 점을 정리했습니다.

AI 워크로드는 학습 단계와 데이터 특성에 따라 스토리지 요구사항이 달라집니다. 고성능과 확장성을 함께 고려해 블록, 파일, 오브젝트 스토리지를 비교하고 하이브리드 구성을 제안했습니다.
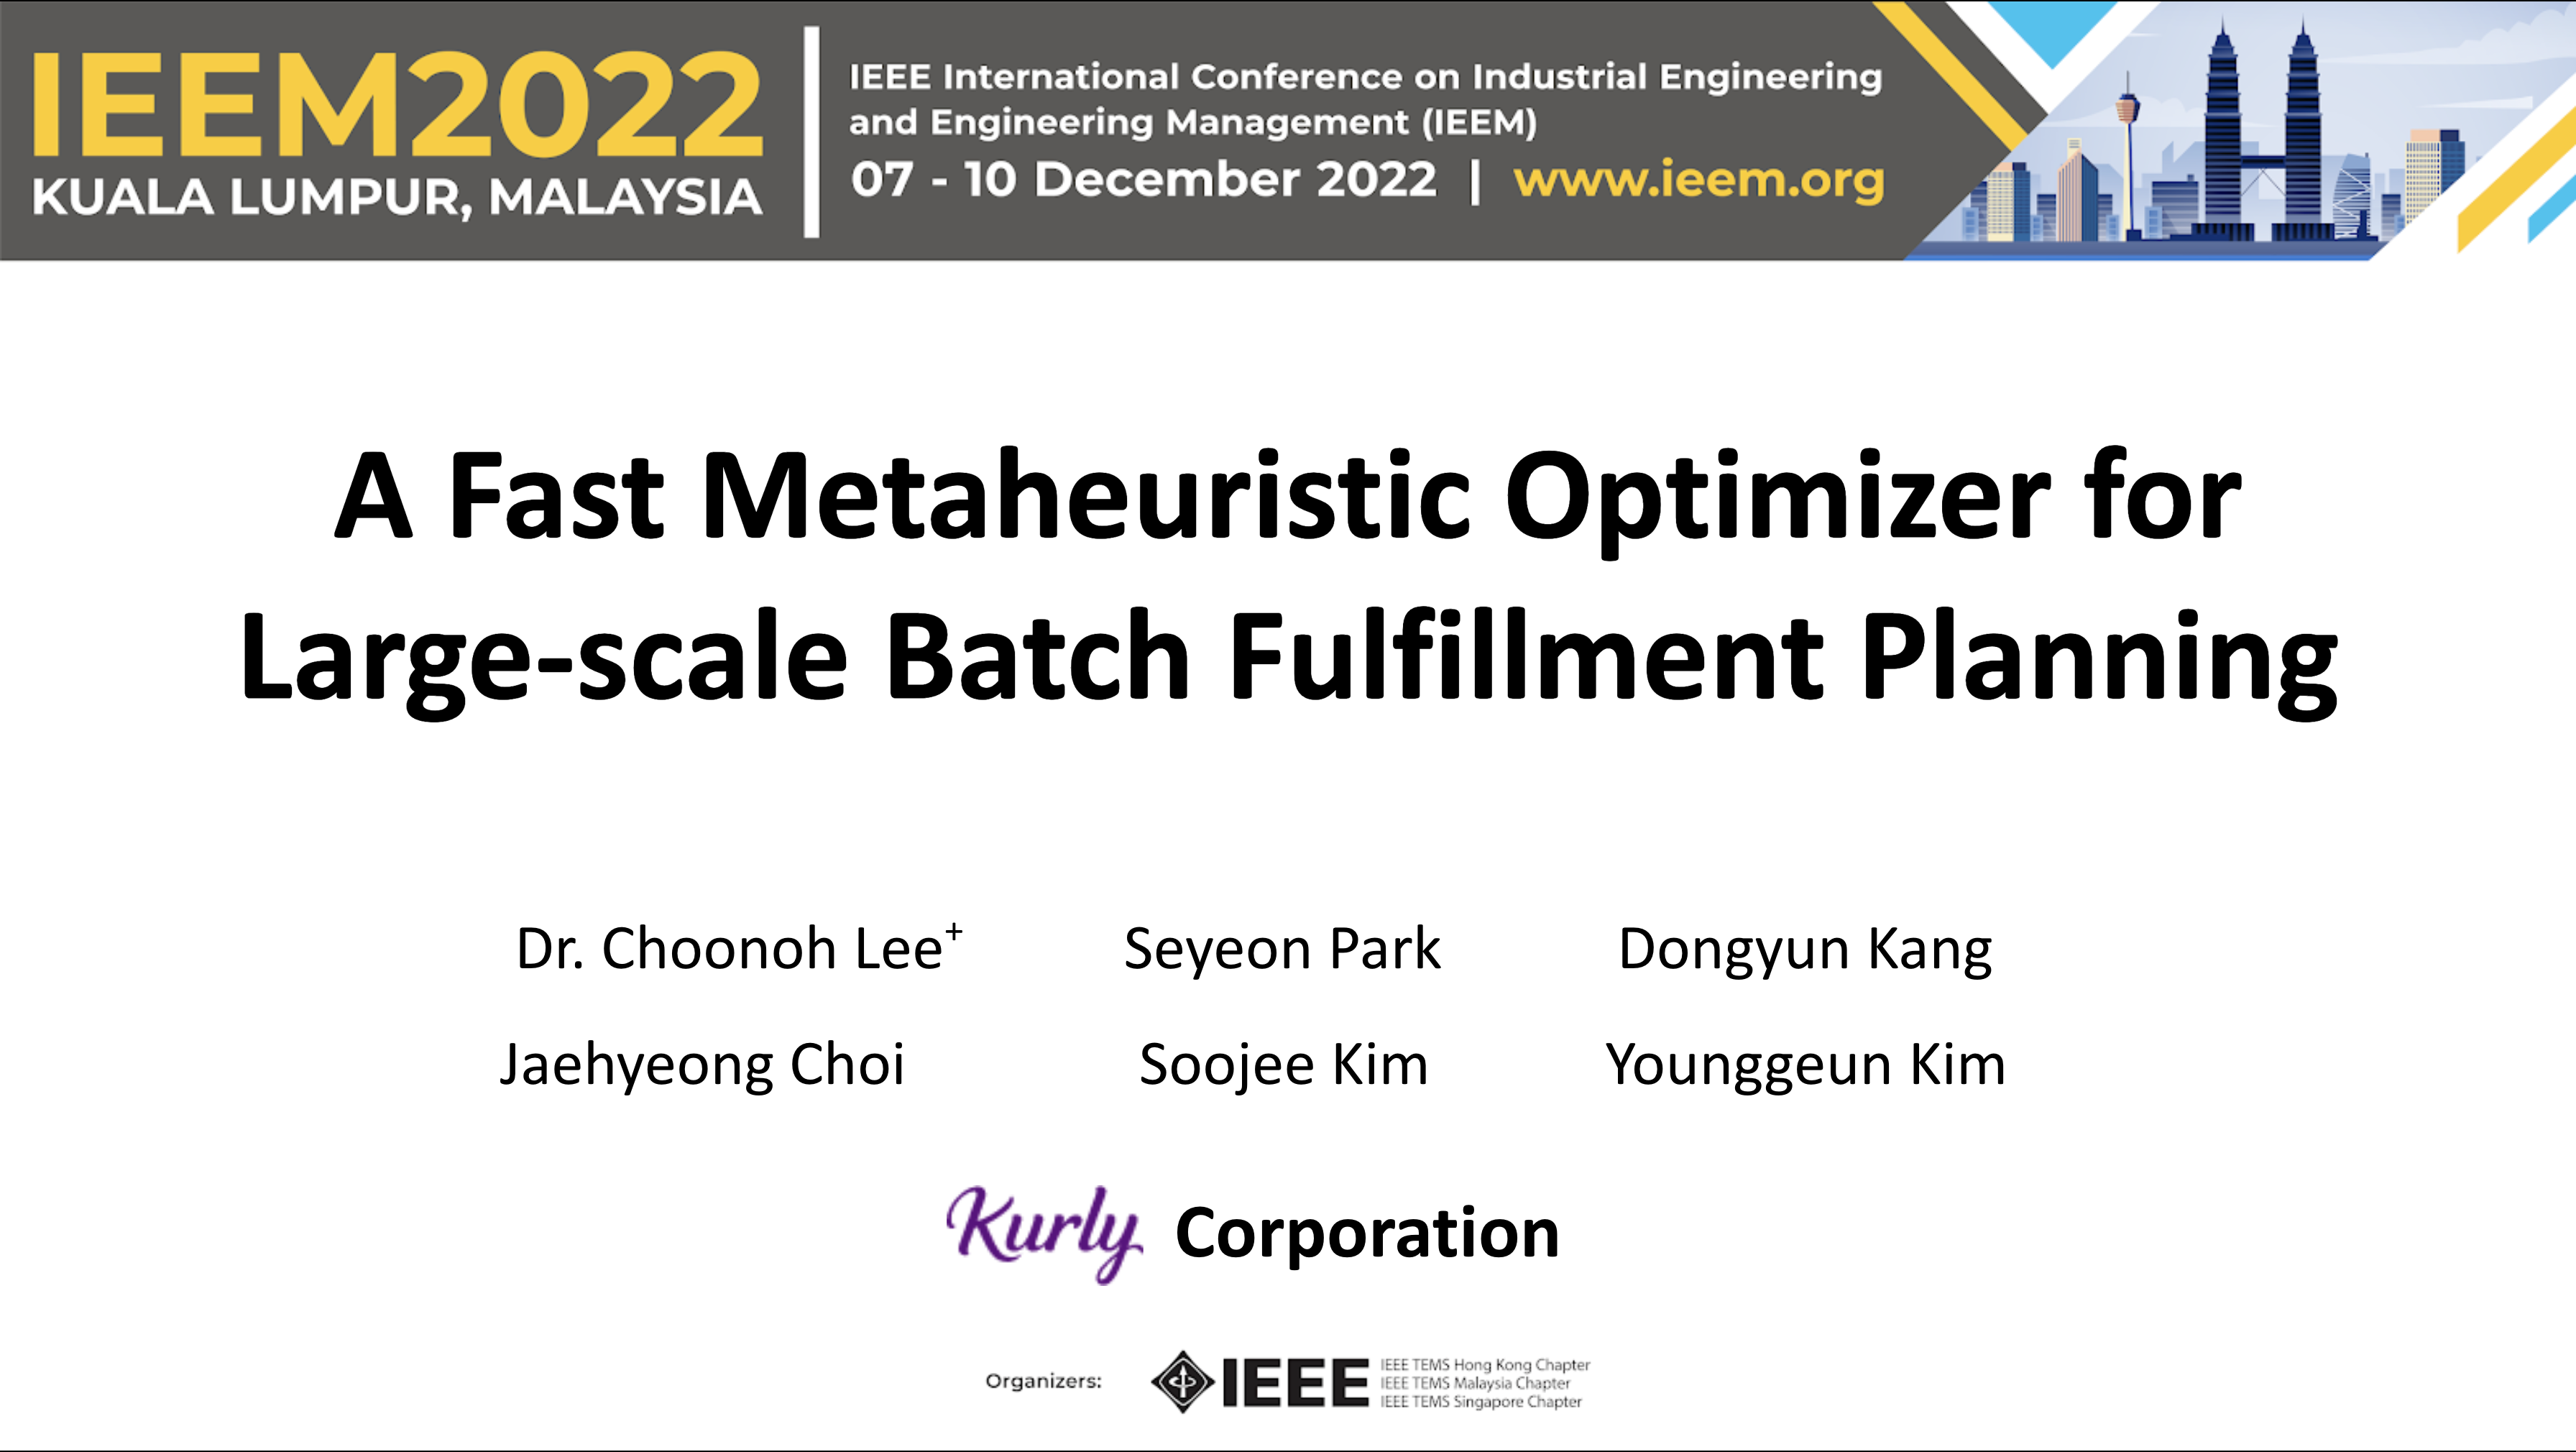
컬리는 배치 피킹 물류센터의 생산 계획을 유전 알고리즘으로 최적화하는 논문을 발표했습니다. 고유 상품 수가 적은 배치 계획을 탐색해 현장 생산성 향상을 검증하고 있습니다.

검색 기반 챗봇의 답변 DB 한계를 넘어 Luda Gen 1 생성 기반 챗봇을 도입했습니다. 2.3B PLM과 시간·화자 정보를 활용해 자연스러운 문맥 대화 가능성을 높였습니다.
카카오페이 MLOps 플랫폼에서 ML 모델 학습 파이프라인 설계 사례를 공유했습니다. 플랫폼 관점에서 모델 학습 흐름을 정리한 내용입니다.
SMT 공정의 chip mount planning을 강화학습으로 최적화한 초기 결과를 소개했습니다. 33개 sample 실험과 IPC sample 분석을 통해 적용 가능성과 개선 과제를 확인했습니다.

커머스 시계열 지표의 급변을 자동 감지하기 위해 온라인 CPD와 SDAR 기반 모델을 도입했습니다. Airflow와 Glue로 ETL·알림 파이프라인을 구성해 Slack 경보까지 연결했습니다.

Apache Beam RunInference로 Dataflow 기반 대규모 모델 추론 파이프라인을 구성하는 방법을 소개했습니다. 가변 길이 입력의 패딩 처리와 배치·GPU 지표 관리 포인트를 설명합니다.

리디 데이터사이언스팀이 기존 시스템을 활용해 머신러닝 파이프라인을 구축한 사례를 소개했습니다. 학습, 배포, A/B 테스트, 모니터링까지 유기적으로 연결해 운영 효율을 높였습니다.
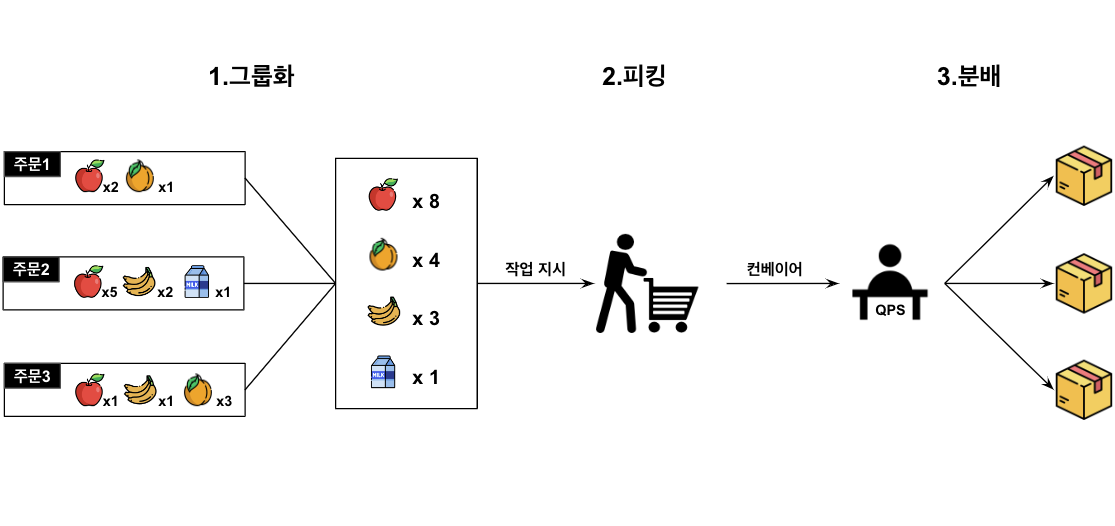
확률적 작업자 행동을 MLE·회귀분석으로 추정해 물류센터 Digital Twin을 구축했습니다. 유전 알고리즘의 처리 시간 감소와 실제 현장 상품 가짓수 감소를 검증했습니다.

친구 같은 이미지 반응을 위한 이미지 코멘팅 데이터셋과 리트리벌·생성 모델을 비교했습니다. Swin Transformer 기반 리트리벌 모델을 포토챗 베타에 적용하고 멀티턴·Scene Text 활용을 과제로 제시했습니다.
도구 분산으로 커진 ML 실험 환경의 복잡성을 해결하기 위해 Kubeflow를 도입했습니다. Elyra, S3·IRSA, SealedSecrets 기반의 운영 설정과 보안 관리 팁을 공유합니다.