
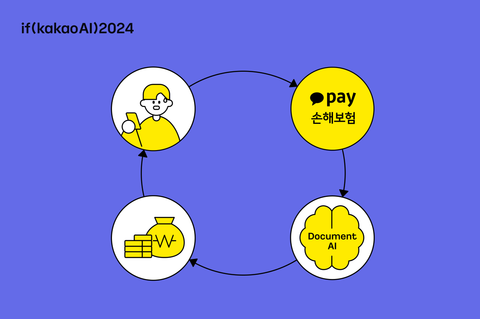
Document AI로 문서 검토 한방에 끝내기
보험금 청구 문서를 사람 대신 Document AI로 하루 3,000장 처리하는 사례를 소개했습니다. 어떤 모델과 방식으로 구현했는지에 대한 개요를 다뤘습니다.
#OCR
2800

보험금 청구 문서를 사람 대신 Document AI로 하루 3,000장 처리하는 사례를 소개했습니다. 어떤 모델과 방식으로 구현했는지에 대한 개요를 다뤘습니다.

독일 법원의 LAION 판결을 통해 AI 학습용 데이터 수집과 저작권 보호의 균형을 살펴보았습니다. 국내 AI 기업도 TDM 예외와 opt-out 쟁점을 주의 깊게 확인할 필요가 있습니다.

롱테일 상품과 간헐적 수요의 차이를 설명하고, 수요 패턴 분류 기준과 예측 난점을 정리했습니다. 또한 Croston 계열 기법과 머신러닝을 함께 쓰는 실무 전략을 소개했습니다.

GPT와 프롬프트 엔지니어링으로 메뉴 이미지 검수를 자동화한 사례를 소개했습니다. 수동 검수 병목을 줄이고, 구조화된 응답과 하이브리드 운영으로 정확도와 효율을 높였습니다.

GitLab의 MLOps 기능과 역할을 소개하며 모델 관리와 배포 자동화를 설명했습니다. Model registry와 실험 추적 기능으로 협업과 운영 효율을 높이는 방향을 제시했습니다.
GitLab의 MLOps 기능을 중심으로 모델 등록과 실험 추적 방식을 살펴봤습니다. CI/CD와 연동해 ML 배포와 관리를 자동화하는 흐름을 소개했습니다.
네이버는 서치피드 SURF로 검색을 결과 나열이 아닌 연속적 탐색 경험으로 확장했습니다. LLM 기반 임베딩, 맥락텍스트, 실시간 피드백으로 개인화와 최신성을 함께 강화했습니다.

AWS re:Invent 2024에서 소개된 S3, Aurora DSQL, Bedrock, SageMaker, Nova 등의 신규 기능을 정리했습니다. 대규모 데이터 관리, 글로벌 DB, AI 모델 경량화와 GPU 효율화 관점의 참고 포인트를 담았습니다.

여기어때 해커톤에서 Gen AI 기반 숙소 추천 챗봇을 구현한 과정을 공유했습니다. ChatGPT, STT, Vision API, 해시태그 추천을 조합해 검색과 추천 기능을 구성했습니다.
오픈 소스 LLM의 한계를 보완하는 RAG를 소개하는 튜토리얼 글입니다. 설치된 LLM을 활용해 검색 증강 생성 방식을 설명합니다.
VLM과 LLM을 활용해 멀티모달 학습 데이터를 만드는 방법을 소개했습니다. OCR, 프롬프트 엔지니어링, 후처리로 수작업 라벨링의 비용과 시간을 줄였습니다.

Cursor, Windsurf, Aider로 Todo 앱을 구현한 결과를 비교했습니다. 각 도구의 속도, 완성도, 사용 방식 차이를 함께 살펴봤습니다.

숙소 사진을 AI로 태깅해 유사 숙소를 찾는 프로토타입 사례를 소개했습니다. 이미지 비교의 한계를 넘기 위해 Google Cloud Vision API와 태그 기반 매칭을 활용했습니다.

LangChain 기반 노코드 플랫폼 LangFlow를 HuggingFace Spaces에서 시작하는 방법을 소개했습니다. 드래그 앤 드롭으로 플로우를 만들고 OpenAI API로 기본 챗봇을 구성하는 흐름을 다뤘습니다.