

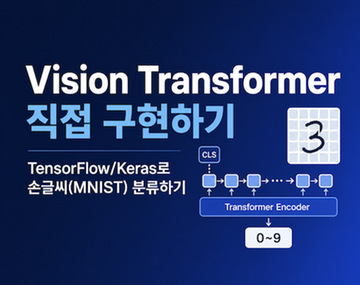

Vision Transformer 구현 — TensorFlow/Keras로 손글씨(MNIST) 분류하기
Vision Transformer를 TensorFlow/Keras로 구현해 MNIST 손글씨 분류 과정을 단계별로 설명했습니다. 데이터 전처리부터 패치화, 어텐션, 인코더, 분류까지 텐서 흐름과 구현 포인트를 정리했습니다.
#Vision Transformer#TensorFlow
3300
새로운 기술 블로그가 추가되었어요
Vision Transformer를 TensorFlow/Keras로 구현해 MNIST 손글씨 분류 과정을 단계별로 설명했습니다. 데이터 전처리부터 패치화, 어텐션, 인코더, 분류까지 텐서 흐름과 구현 포인트를 정리했습니다.

Amazon Bedrock과 TensorFlow를 결합해 렌탈 제품 추천과 자연어 데이터 조회를 자동화한 사례를 소개했습니다. 고객 추천과 내부 분석을 함께 지원해 선택 피로도와 데이터 활용 한계를 줄였습니다.

Two-Tower 모델로 추천시스템의 후보 검색 단계와 학습 방식을 개선한 적용 사례를 다루었습니다. In-Batch Sampled SoftMax, LogQ Correction, ScaNN 활용과 운영 모니터링까지 함께 소개했습니다.

LLM의 무작정 큰 모델 경쟁 한계를 짚고 MoE의 구조와 장점을 정리했습니다. 또한 실제 서비스에서 필요한 메모리, 통신, 로드 밸런싱 최적화 포인트를 설명했습니다.

안드로이드에서 DistilKoBERT 기반 스팸 분류 모델을 온디바이스 AI로 구현한 과정을 정리했습니다.\nTFLite 변환과 양자화로 모델 크기와 추론 속도를 개선하고 단말 벤치마크 결과도 확인했습니다.


구글 머신러닝 부트캠프 2023 4기 모집 소식입니다. 이론과 실습, 멘토링과 채용 연계를 함께 제공하는 3개월 온라인 프로그램입니다.


Apache Beam RunInference로 Dataflow 기반 대규모 모델 추론 파이프라인을 구성하는 방법을 소개했습니다.\n가변 길이 입력의 패딩 처리와 배치·GPU 지표 관리 포인트를 설명합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

TFX 커스텀 컴포넌트로 신규 데이터부터 학습·모델 등록까지의 파이프라인을 구성했습니다. Apache Beam과 사내 레지스트리를 연동하는 구현·운영 주의점을 설명합니다.

AWS Inferentia 기반 TensorFlow 모델 서빙의 정합성 검증과 EKS 배포 과정을 소개했습니다. 토크나이저 분리와 동적 배치로 처리량을 높이고 비용 절감 가능성을 확인했습니다.

AWS Inferentia로 TensorFlow RoBERTa 모델을 컴파일하고 GPU 인스턴스와 비용·성능을 비교했습니다. 1000RPS 기준 Inferentia의 높은 비용 효율과 동적 그래프 제약을 함께 정리했습니다.


비정형 화장품 리뷰에서 약 80개 제품 속성을 추출하는 멀티 출력 딥러닝 모델을 개발했습니다.\n토픽 추가와 운영 부담을 줄이고, 0.85~0.95 정확도 및 제품 특성 검증 결과를 확인했습니다.
Ubuntu 20.04 CLI 서버에서 CUDA 11.1 기반 GPU 가속 환경 구성을 정리했습니다. 드라이버·CUDA·cuDNN·딥러닝 프레임워크의 호환성과 검증 방법을 안내합니다.

TensorFlow 기반 N-gram 마스킹 위치 계산 병목을 C++ Custom Op으로 교체했습니다. 문장당 처리 시간을 4.697ms에서 17.147μs로 줄이며 약 250배 성능을 개선했습니다.

PyTorch 리서치와 TensorFlow Serving 배포를 병행한 모델 운영 방식을 소개했습니다. 양방향 가중치 변환과 결과 비교 테스트, 레이어별 차이 대응 방법을 정리했습니다.