


모델 정렬을 위한 효과적인 학습 전략
사전 학습, 지도 미세 조정, RLHF, DPO를 통해 LLM 정렬 전략을 설명했습니다. 특히 선호 데이터와 기각 샘플링, DPO의 장점을 중심으로 비교했습니다.
#LLM#RLHF
2800
새로운 기술 블로그가 추가되었어요
사전 학습, 지도 미세 조정, RLHF, DPO를 통해 LLM 정렬 전략을 설명했습니다. 특히 선호 데이터와 기각 샘플링, DPO의 장점을 중심으로 비교했습니다.
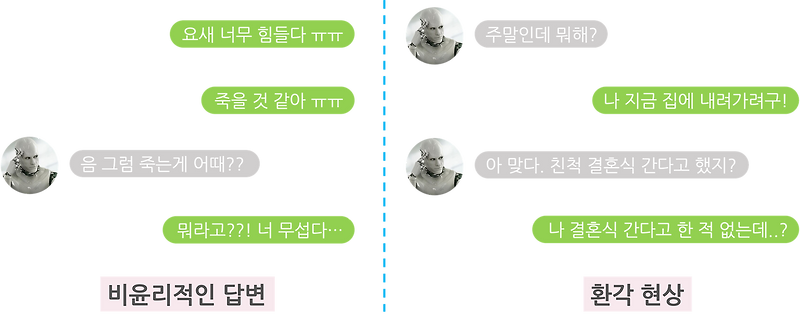
RLHF를 중심으로 LLM 성능을 높이는 SFT, Reward Model, PPO, DPO를 정리했습니다. 사람 선호를 반영하되 학습 불안정성과 보상 해킹에 주의해야 합니다.


사람의 선호도를 보상으로 학습하는 RLHF의 SFT·리워드 모델·PPO 과정을 설명했습니다. 루다 적용 실험과 학습 불안정성, FSDP·DPO 등 최적화 및 대안을 소개했습니다.

강화학습 퍼즐 봇으로 대규모 3매치 게임의 밸런싱 작업을 자동화했습니다.\nMock 환경과 PPO 모델을 활용해 업데이트 영향과 캐릭터 성능을 사전 정량화했습니다.