국내 IT 기업 기술 블로그 최신 글

필터 1
[데이터센터 입문 시리즈] 데이터센터 전력은 어떻게 끌어올까? 발전소에서 서버까지
가비아
데브옵스

[데이터센터 입문 시리즈] 데이터센터 전력은 어떻게 끌어올까? 발전소에서 서버까지

데이터센터 전력이 송전망부터 서버까지 전달되는 5단계와 수변전 구조를 설명했습니다. 계약전력별 수전 전압, 이중 수전의 비용·안정성 차이를 정리했습니다.

#데이터센터#전력
500
컨테이너처럼 쓰고, VM처럼 격리하기 3편 - Fabric Manager 파티션과 DRA를 이용한 GPU 할당
네이버 D2
데브옵스

컨테이너처럼 쓰고, VM처럼 격리하기 3편 - Fabric Manager 파티션과 DRA를 이용한 GPU 할당

Fabric Manager 파티션 제약을 DRA와 SharedCounters로 표현해 GPU를 안전하게 할당했습니다. Kata VM 콜드 플러그 경로를 보완해 베어메탈 수준의 NCCL 대역폭을 확인했습니다.

#Kubernetes#DRA
400
컨테이너처럼 쓰고, VM처럼 격리하기 2편 - GPU 패스스루 계층과 GPU 8장 VM의 부팅·메모리 구성
네이버 D2
데브옵스

컨테이너처럼 쓰고, VM처럼 격리하기 2편 - GPU 패스스루 계층과 GPU 8장 VM의 부팅·메모리 구성

Kata Containers VM에 GPU를 연결하는 IOMMU·VFIO·CDI 계층과 PCIe 격리 방식을 설명했습니다. THP와 1GiB hugepage로 GPU 8장 VM의 부팅 지연을 줄인 사례를 다뤘습니다.

#Kubernetes#Kata Containers
700
컨테이너처럼 쓰고, VM처럼 격리하기 1편 - 컨테이너와 VM의 차이, Kata Containers의 Pod 실행 구조
네이버 D2
데브옵스

컨테이너처럼 쓰고, VM처럼 격리하기 1편 - 컨테이너와 VM의 차이, Kata Containers의 Pod 실행 구조

GPU 공유 Kubernetes 환경에서 Kata Containers로 Pod별 VM 격리를 구성한 배경을 설명했습니다. KVM·QEMU·virtio와 Pod 네트워크 연결 흐름을 정리했습니다.
#Kubernetes#Kata Containers
1200
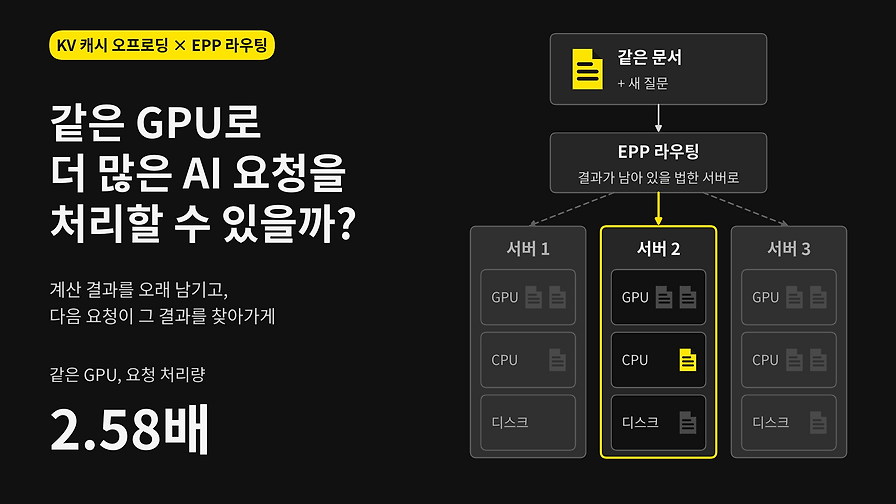
같은 GPU로 더 많은 AI 요청을 처리할 수 있을까? ― KV 캐시 오프로딩 × EPP 라우팅: 계산 결과를 오래 남기고, 다음 요청이 그 결과를 찾아가게 하기
카카오
AI

같은 GPU로 더 많은 AI 요청을 처리할 수 있을까? ― KV 캐시 오프로딩 × EPP 라우팅: 계산 결과를 오래 남기고, 다음 요청이 그 결과를 찾아가게 하기

KV 캐시 오프로딩과 EPP 라우팅으로 계산 결과를 재활용하는 방식을 다룹니다. 동일 GPU 32장에서 3,456건 처리 시간을 121.7분에서 47.2분으로 줄였습니다.

#GPU#KV 캐시
1400
Image AI 서빙 최적화: CPU와 GPU의 빈 시간을 줄여 H100 67장을 절감하기까지
네이버 D2
AI

Image AI 서빙 최적화: CPU와 GPU의 빈 시간을 줄여 H100 67장을 절감하기까지

Image AI 서빙을 LitServe로 전환하고 CPU·GPU 대기 및 불필요한 연산을 줄였습니다. 트래픽 기반 튜닝과 GPU 공유로 H100 환산 약 67장을 절감했습니다.

#LitServe#GPU
2400
흩어진 행동을 연결하다: 네이버 전 지면의 사용자 행동을 학습하는 추천 모델 개발기
네이버 D2
AI

흩어진 행동을 연결하다: 네이버 전 지면의 사용자 행동을 학습하는 추천 모델 개발기

검색·피드·광고 데이터를 연결하는 버티컬 추천 모델의 개발과 적용 경험을 소개합니다. 실시간 GPU 서빙 최적화와 지식 증류 기반 도메인 간 지식 전이를 다룹니다.

#추천 시스템#GPU
900
쿠팡 파트너스

광고

개발자를 위한 서적을 확인해 보세요

이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
#개발서적#프로그래밍
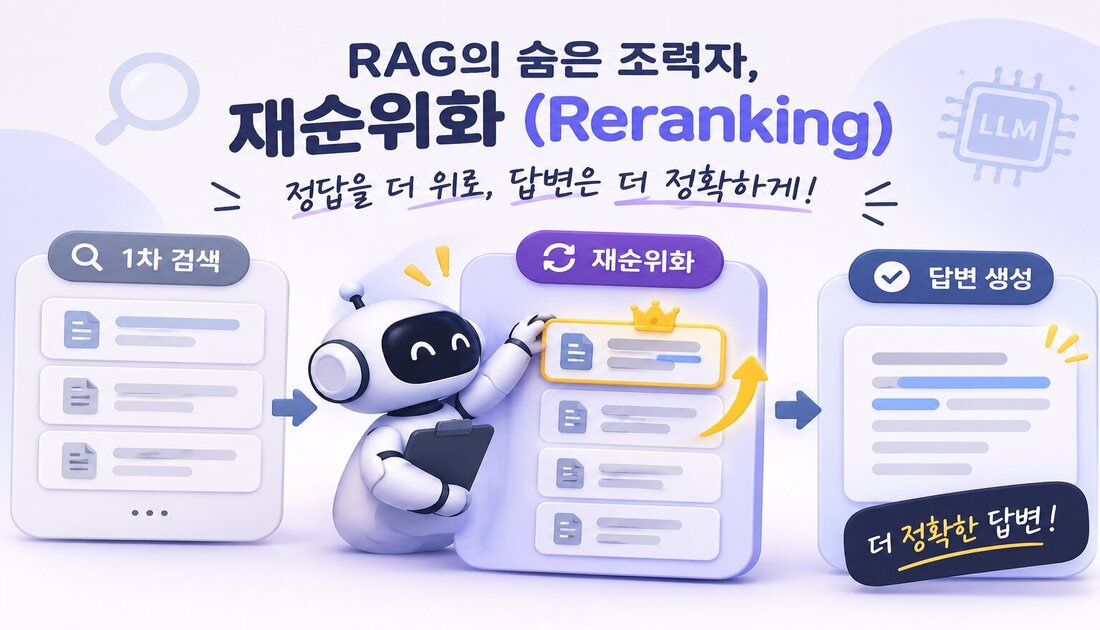
RAG 시스템의 재순위화(Reranking): 구조와 발전부터 리랭커 선정까지
CSLEE
AI

RAG 시스템의 재순위화(Reranking): 구조와 발전부터 리랭커 선정까지

RAG 재순위화의 구조와 기술 발전, 운영 설정, 모델 선정 기준을 정리했습니다. 한국어 기업 문서 실험으로 정확도·속도·GPU 비용의 차이를 비교했습니다.

#RAG#LLM
3000
GPUaaS란? 서비스형 GPU의 개념·구조·과금 방식 정리
가비아
AI

GPUaaS란? 서비스형 GPU의 개념·구조·과금 방식 정리

GPUaaS의 IaaS 기반 책임 범위와 인스턴스·베어메탈 중심 구성 요소를 정리했습니다. 과금 방식과 GPU 메모리·클러스터 네트워크·보안 책임의 도입 기준을 설명합니다.

#GPUaaS#IaaS
2400
[기술 가이드] Kubernetes의 핵심 변화: DRA를 통한 GPU 자원 동적 할당
KT 클라우드
데브옵스

[기술 가이드] Kubernetes의 핵심 변화: DRA를 통한 GPU 자원 동적 할당

Kubernetes 1.34의 DRA와 ResourceClaim으로 조건 기반 GPU 할당 방식을 설명했습니다. CDI 장치 주입과 MIG 자동 설정을 통한 GPU 운영 변화를 정리했습니다.

#Kubernetes#DRA
1800
[기술 분석] Ampere부터 Vera Rubin까지, GPU 진화가 바꾼 북미 AIDC 인프라
KT 클라우드
데브옵스

[기술 분석] Ampere부터 Vera Rubin까지, GPU 진화가 바꾼 북미 AIDC 인프라

GPU 전력 밀도 증가가 북미 AI 데이터센터의 배전과 냉각 구조를 바꾼 과정을 분석했습니다. 480V 배전과 직접액체냉각, CDU 운영 및 설비 노후화 위험을 정리했습니다.

#NVIDIA#GPU
800
[데이터센터 입문 시리즈] 같은 GPU인데 왜 성능이 다를까? 보관 장소가 만드는 차이
가비아
데브옵스

[데이터센터 입문 시리즈] 같은 GPU인데 왜 성능이 다를까? 보관 장소가 만드는 차이

GPU 실성능은 사양뿐 아니라 냉각·전력·네트워크·랙 배치·가동률에 따라 달라집니다. 데이터센터 비교 시 설비 균형과 장애 복구 체계를 함께 확인해야 합니다.

#GPU#데이터센터
1900
컨테이너처럼 쓰고, VM처럼 격리하기
네이버 D2
데브옵스

컨테이너처럼 쓰고, VM처럼 격리하기

Kubernetes GPU 노드를 Kata Containers 기반 VM으로 격리하는 발표를 소개합니다. GPU·NIC 할당과 VM 부팅·성능 최적화 방안을 다룹니다.
#Kubernetes#Kata Containers
3100
MoE란? AI 모델 구조 MoE(전문가 혼합)의 개념·원리·장단점 쉽게 이해하기
노타
AI

MoE란? AI 모델 구조 MoE(전문가 혼합)의 개념·원리·장단점 쉽게 이해하기

MoE의 토큰별 라우팅, 총·활성 파라미터, 밀집 구조 대비 계산 효율을 설명했습니다. 메모리 요구량과 양자화 난점, 이를 줄이는 NMQ 접근도 소개했습니다.

#MoE#LLM
2000