

레거시 GPU에 날개 달기: 극한의 서빙 최적화 가이드

레거시 GPU에 날개 달기: 극한의 서빙 최적화 가이드
BERT 기반 SPLADE 모델의 대규모 실시간 서빙 최적화 방법을 소개했습니다. FlashTokenizer와 전/후처리, 추론 최적화로 레거시 GPU 성능을 끌어올린 사례입니다.
#BERT#LLM
10300
새로운 기술 블로그가 추가되었어요
BERT 기반 SPLADE 모델의 대규모 실시간 서빙 최적화 방법을 소개했습니다. FlashTokenizer와 전/후처리, 추론 최적화로 레거시 GPU 성능을 끌어올린 사례입니다.
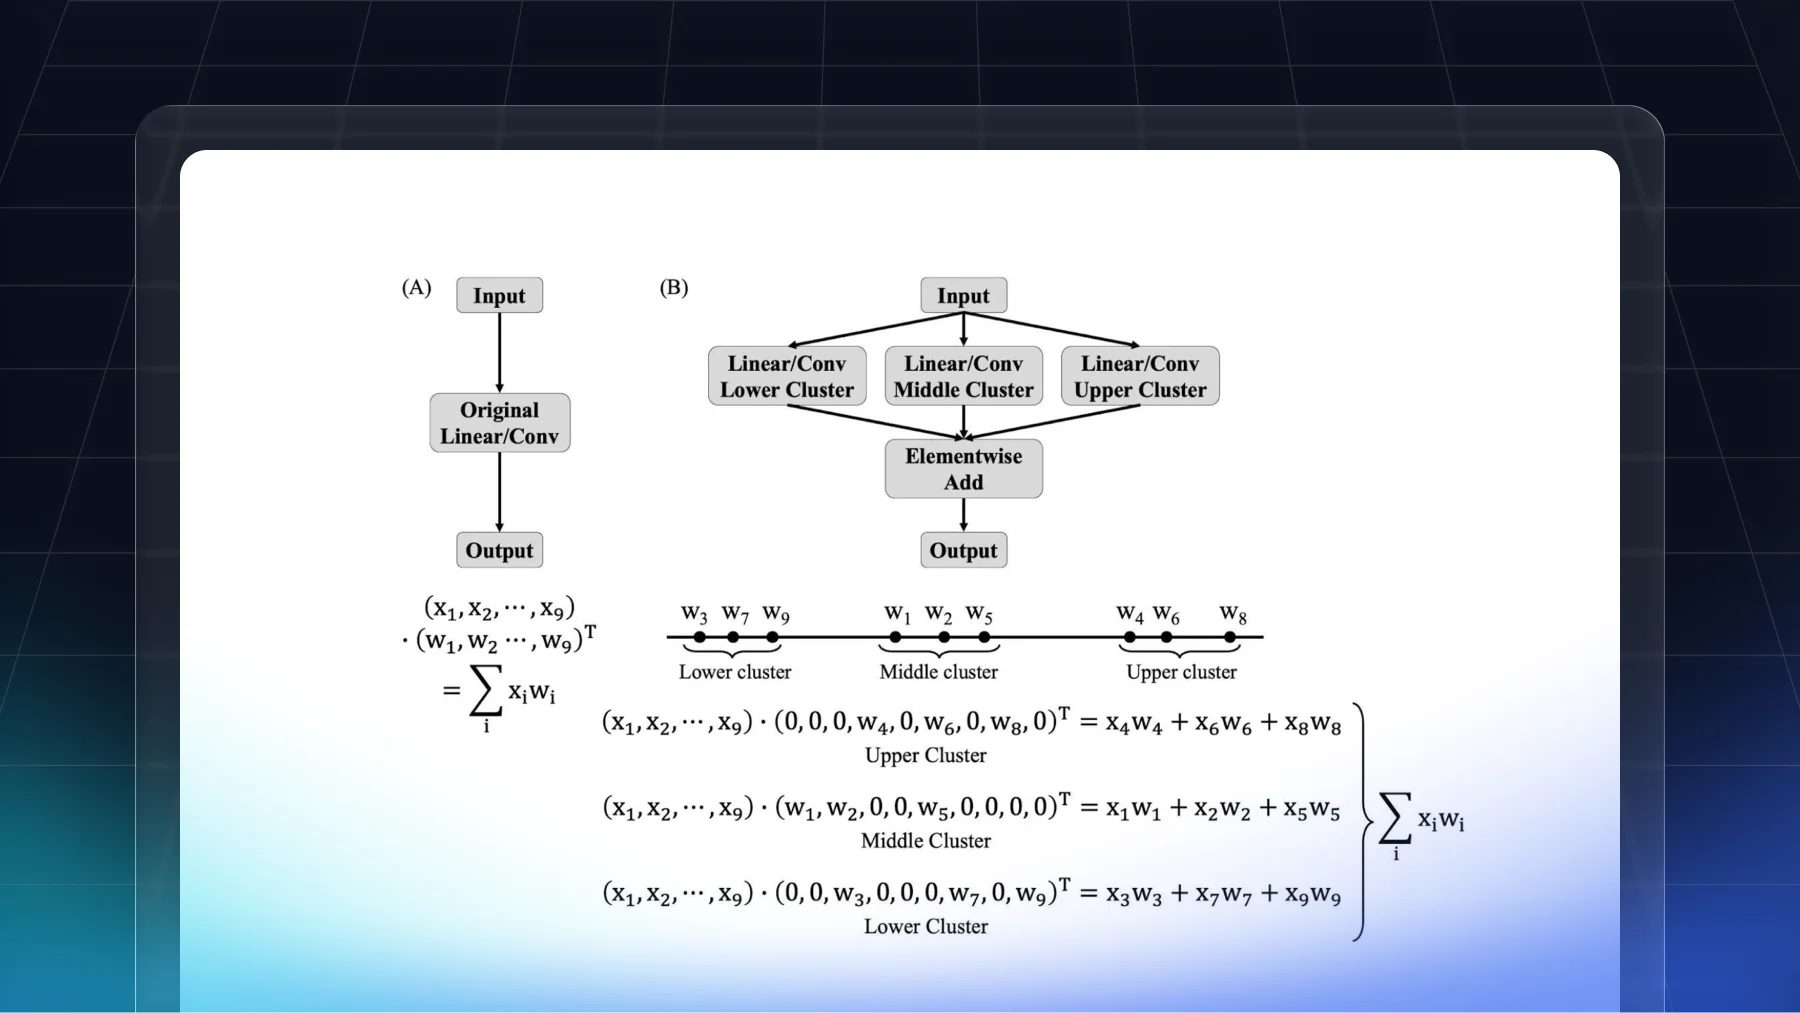
SplitQuant는 레이어를 클러스터 기반으로 분할해 저비트 양자화의 이상치 영향을 줄였습니다. BERT-Tiny 실험에서 INT2 정확도를 FP32 수준에 가깝게 향상했습니다.

텍스트를 숫자와 벡터로 표현하는 여러 방법과 문장 임베딩 기반 의미 검색을 정리했습니다. 또한 BERT, FAISS, 하이브리드 검색의 구조와 활용 방향을 소개했습니다.
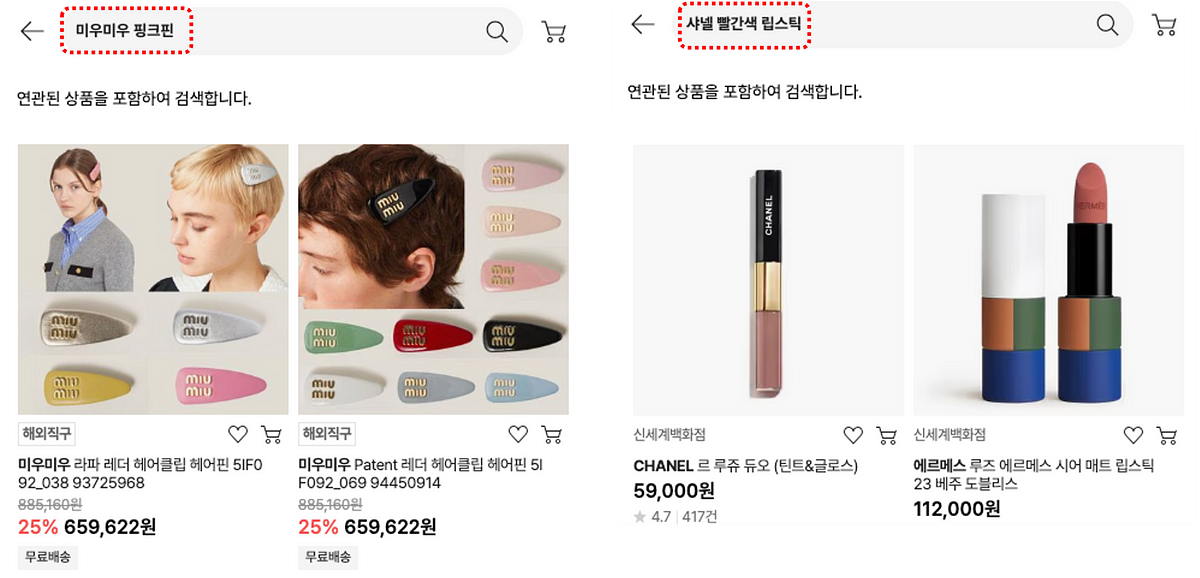
SSG.COM 검색 실패를 줄이기 위해 BERT 계열 모델과 벡터 DB 기반 매칭 방식을 도입했습니다. 적용 후 전체 검색 실패의 46%를 성공으로 전환했고 정확도 75%를 달성했습니다.
QueryPie의 AI 분류기로 개인정보를 문맥 기반으로 식별하고 규제 준수를 지원하는 방법을 소개했습니다. 정규식 기반 한계를 보완하며 정확도와 운영 효율을 높인 사례를 설명했습니다.
상위·하위 인텐트를 함께 추론하는 챗봇을 위해 MTL 기반 PLE 모델과 CurricularFace loss를 적용했습니다. 기존 앙상블보다 성능과 관리 효율을 함께 개선한 사례를 소개했습니다.


ACL 2022의 NLP 연구 12편을 프롬프트, 문장 표현, 대화, 멀티모달 평가 관점에서 리뷰했습니다. 대조 학습과 평가 체계 개선 등 주요 제안과 실험 결과를 정리했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

카카오페이는 이용 이력을 Feature·모델·세그먼트로 가공하는 페이프로파일 구조를 소개했습니다. 분류·NLP·GNN 기술로 개인화 서비스와 마이데이터 활용을 고도화합니다.


BERT의 대표 NLP 과제와 데이터셋을 입력·출력 구조 중심으로 정리했습니다. 이를 이력서 필터링, 평가 코멘트 분석, 채용 Q&A에 적용하는 방안을 제시합니다.


뷰티 리뷰·제품 정보와 공개 데이터를 학습한 도메인 특화 ELECTRA 기반 PLM 개발 과정을 소개했습니다. 리뷰 분류 성능을 높이고 검수 자동화와 제품 속성 추출에 적용했습니다.
뉴스 정보를 이용해 고용률 변화를 예측하는 멀티모달 모델 개발 과정을 소개했습니다. 이번 글에서는 고용 기사 분류와 감정 분석을 위한 KoELECTRA 기반 설계를 다뤘습니다.

대형 BERT 기반 대화 모델을 Knowledge Distillation으로 경량화한 사례를 소개했습니다. 임베딩·로짓 증류로 약 3배 추론 속도와 높은 정확도를 확보했습니다.

Transformer 활용과 경량화 연구를 중심으로 시즌 5 ML 세미나 자료를 공유했습니다. 지식 증류, 양자화, 프루닝, NLP·기계번역 관련 논문 발표를 정리했습니다.

ACL 2020의 제출·합격률과 Generation, Dialogue 등 주요 NLP 연구 경향을 분석했습니다. 대화, 생성, BERT 최적화 관련 논문 24편의 핵심 방법과 성과를 리뷰했습니다.