
LLM은 꼭 한 토큰씩 답해야 할까
LLM은 꼭 한 토큰씩 답해야 할까
확산형 언어모델의 병렬 토큰 예측·반복 정제 방식과 블록 생성, 토큰 편집을 설명했습니다. 도입 시 TPS뿐 아니라 첫 응답 지연, 품질, 비용을 같은 조건에서 비교해야 합니다.
#LLM#Gemini
2400
확산형 언어모델의 병렬 토큰 예측·반복 정제 방식과 블록 생성, 토큰 편집을 설명했습니다. 도입 시 TPS뿐 아니라 첫 응답 지연, 품질, 비용을 같은 조건에서 비교해야 합니다.
AI 모델 양자화의 비트 축소 원리와 INT8·FP8·NVFP4 포맷 차이를 설명합니다. 메모리 절감 효과와 정확도·하드웨어·캘리브레이션의 고려 사항을 다룹니다.
AI 질문은 네트워크와 데이터센터를 거쳐 GPU 추론 후 응답으로 돌아오는 물리적 과정입니다. 질문 한 번의 전력은 작지만 누적되면 데이터센터의 전력과 냉각 과제를 크게 키웁니다.
GTC 2026의 핵심 흐름을 추론 효율, 에이전틱 AI, 피지컬 AI 관점에서 정리했습니다. 데이터센터와 엣지 환경의 조건별 AI 최적화 과제를 짚었습니다.
AI-RAN 시대를 대비해 기지국 내 AI 모델의 추론 가속화와 On-Site Training을 연구하는 글입니다. 엣지 환경에 맞는 모델 적용과 현장 학습 가능성을 다룹니다.


하이퍼엑셀은 EC2 F2 인스턴스와 FPGA를 활용해 LPU 기반 LLM 추론 환경을 클라우드로 구축했습니다. PoC 운영 시간을 크게 줄이고 비용과 보안 부담도 낮췄습니다.
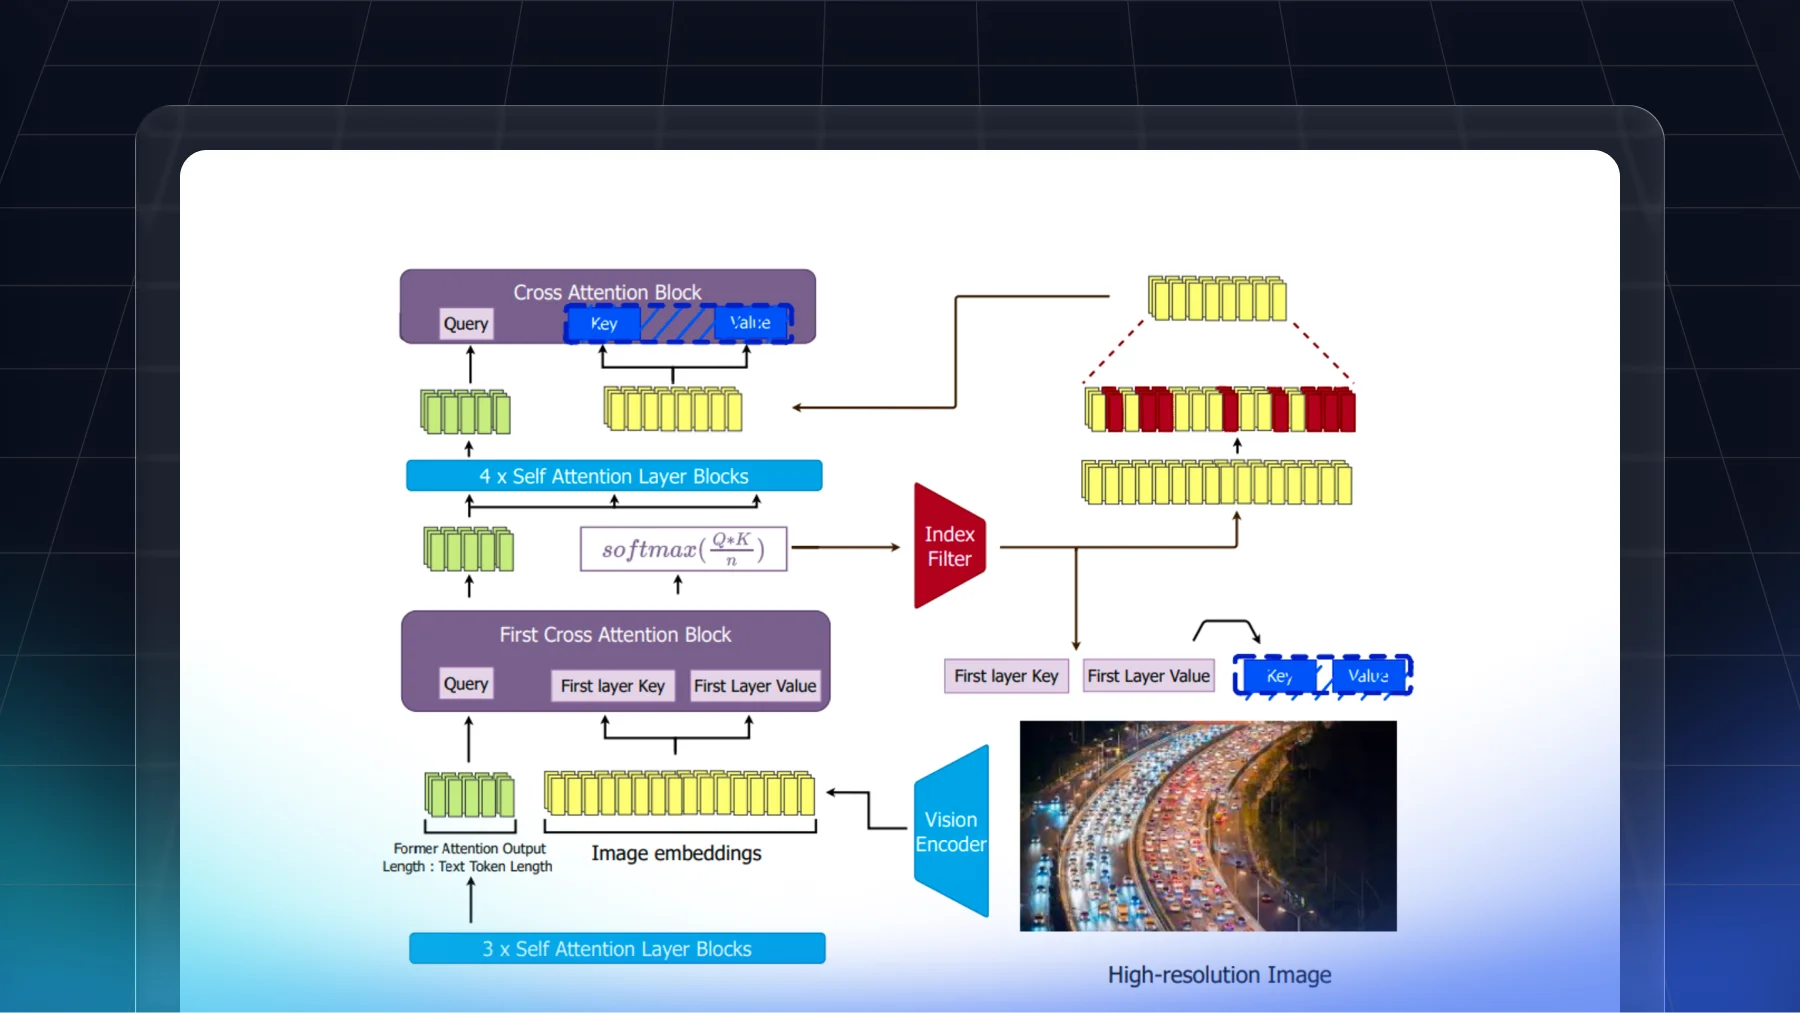
크로스 어텐션의 희소성을 활용해 LLaMA-3.2-Vision의 불필요한 시각 토큰을 제거했습니다. 성능을 유지하며 KV 캐시, 메모리 사용량, 추론 지연을 줄였습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

LLM 시퀀스 생성 구조를 분석해 애플리케이션 지연 시간을 줄이는 방안을 소개합니다. 캐릭터 페르소나 구현 경험을 바탕으로 실시간 응답 성능 최적화 전략을 공유합니다.
Snowflake가 기업 중심 LLM Arctic을 오픈소스로 공개하고, 낮은 훈련비용과 높은 성능을 강조했습니다. Dense-MoE 하이브리드 구조와 FP8 양자화로 추론 효율도 개선했습니다.
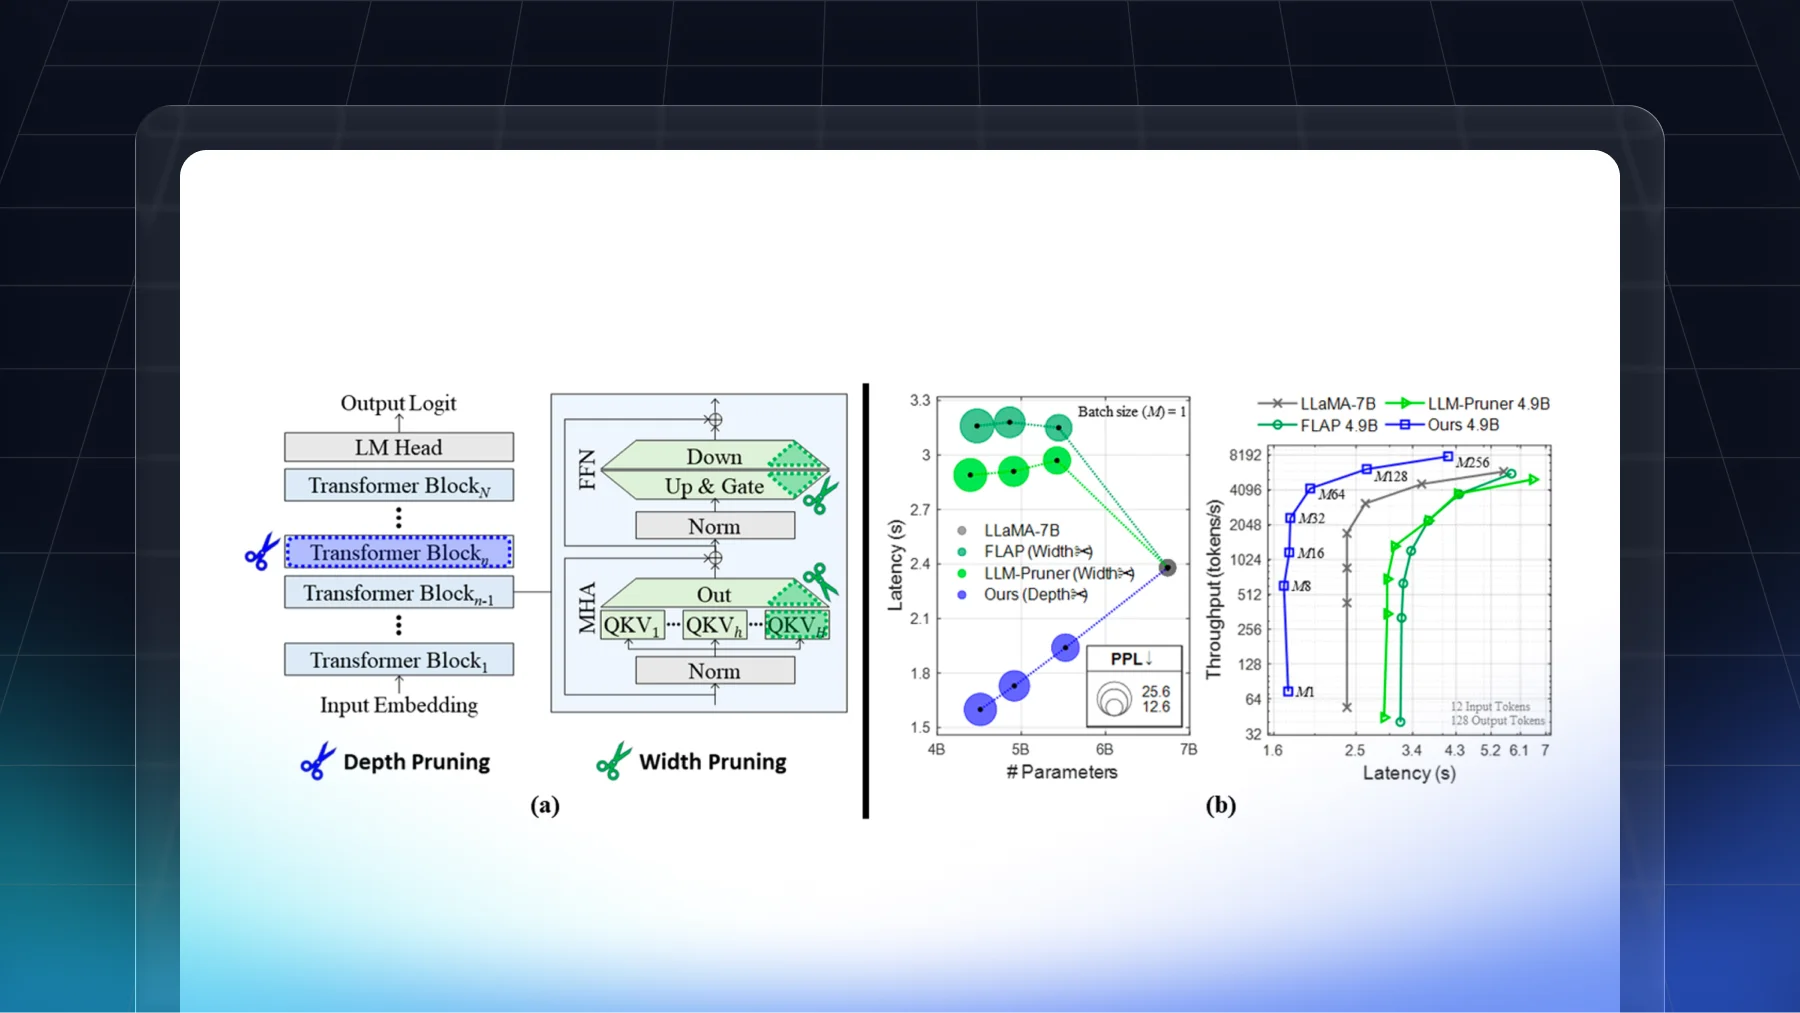
트랜스포머 블록을 제거하는 깊이 가지치기로 LLM 추론 비용과 지연을 줄였습니다. 소규모 배치 환경에서 너비 가지치기보다 빠른 생성 속도와 경쟁력 있는 성능을 보였습니다.