
카카오뱅크가 회고하는 if(kakaoAI)2024 ☕️
카카오뱅크가 회고하는 if(kakaoAI)2024 ☕️
카카오뱅크가 if(kakaoAI)2024에서 LLM 평가·스미싱 탐지·XAI 적용 사례를 공유했습니다. 금융 규제를 고려한 DevOps와 온프레미스 Kubernetes 운영 경험도 소개했습니다.
#컨퍼런스#LLM
3300
카카오뱅크가 if(kakaoAI)2024에서 LLM 평가·스미싱 탐지·XAI 적용 사례를 공유했습니다. 금융 규제를 고려한 DevOps와 온프레미스 Kubernetes 운영 경험도 소개했습니다.

DEVIEW 세션에서 MLOps, LLM, Vision, Web 분야의 네이버 개발 사례를 소개했습니다. LLM 서빙 최적화와 서비스 적용, 웹 성능 관리 등 실무 주제가 중심입니다.


에이닷 뮤직 에이전트에 Multi Prompt Fine-tuning을 적용하며 겪은 시행착오와 개선 과정을 공유했습니다. gpt-4o-mini 전환으로 한글 깨짐과 품질 문제가 크게 완화된 사례였습니다.

LLM과 sLLM의 자체 품질 평가 필요성을 정리하고, 리더보드 사례와 함께 LLM을 활용한 평가 프로세스를 설계한 글입니다. 프롬프트 일관성과 평가 기준 관리 같은 운영 과제도 함께 다뤘습니다.

구글 머신러닝 부트캠프 2024 5기 졸업식과 함께 참가자들의 성과가 공유되었습니다. DLS, 캐글, 젬마 프로젝트를 통해 학습과 협업의 경험을 쌓았습니다.
Google for Developers의 10월 4주차 최신 소식과 주요 블로그 업데이트, 이벤트를 소개했습니다. 관심 있는 제품군의 문서와 행사 정보를 확인해보시면 좋습니다.
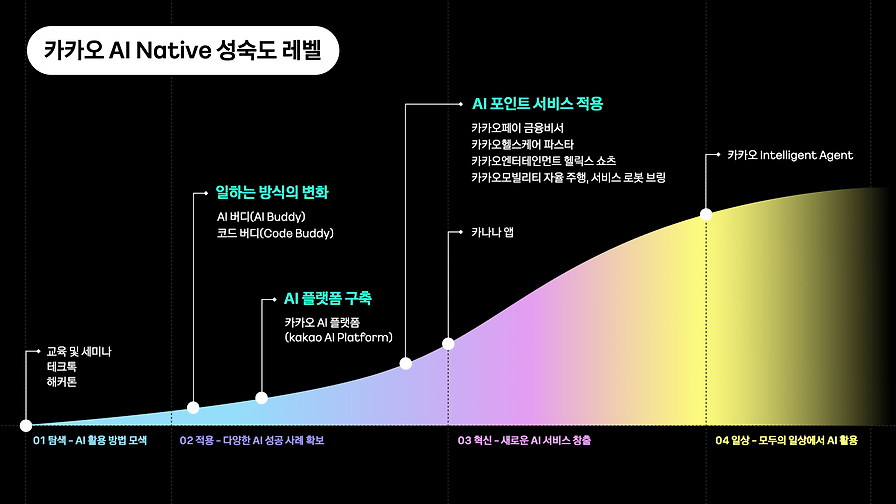
카카오 CTO가 if(kakaoAI)2024에서 AI Native 전략을 소개했습니다. AI를 문화와 서비스 전반에 내재화하려는 방향을 제시했습니다.

생성 AI와 LLM이 자동차에 들어오며 차량 상태 안내, 대화형 어시스턴트, 경로 추천 같은 개인화 기능이 확장되고 있습니다. 또한 비전과 LLM 결합으로 자율주행과 실내 인식의 정확도를 높일 가능성을 보여줍니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

스포츠 중계 영상을 자동으로 숏폼화하는 에이닷 AI숏폼 서비스의 구성과 운영 방식을 소개했습니다. AWS 워크플로우, AI 모델, 모니터링, 비용 최적화로 상용 서비스를 확장한 사례를 설명했습니다.

AWS와 Azure에서 RAG를 구현하는 방식과 구성 요소를 비교해 정리했습니다. 각 플랫폼의 강점이 달라 프로젝트 요구사항에 맞춰 선택할 필요가 있습니다.

쿠팡이 LLM을 활용해 이미지·텍스트 이해, 약한 라벨 생성, 상품 분류를 개선하는 사례를 소개했습니다. 또한 CJK 언어 특성과 ICL·RAG·SFT·CPT, Kubernetes 기반 훈련 흐름을 함께 설명했습니다.

고성능 GPU 클러스터에서 발생하는 통신 비용과 병목 구간을 하드웨어 관점에서 정리했습니다. 스토리지, 서버 내 GPU, 서버 간 통신에 맞춰 NVMe SSD, NVLink, NVSwitch, InfiniBand 선택을 제안했습니다.
무신사 2.0에서 시나리오 기반 설명 가능한 추천 시스템을 구축한 사례를 소개했습니다. 장기·단기 행동을 함께 반영해 개인화와 다양성을 높이고, A/B 테스트와 모니터링으로 운영했습니다.
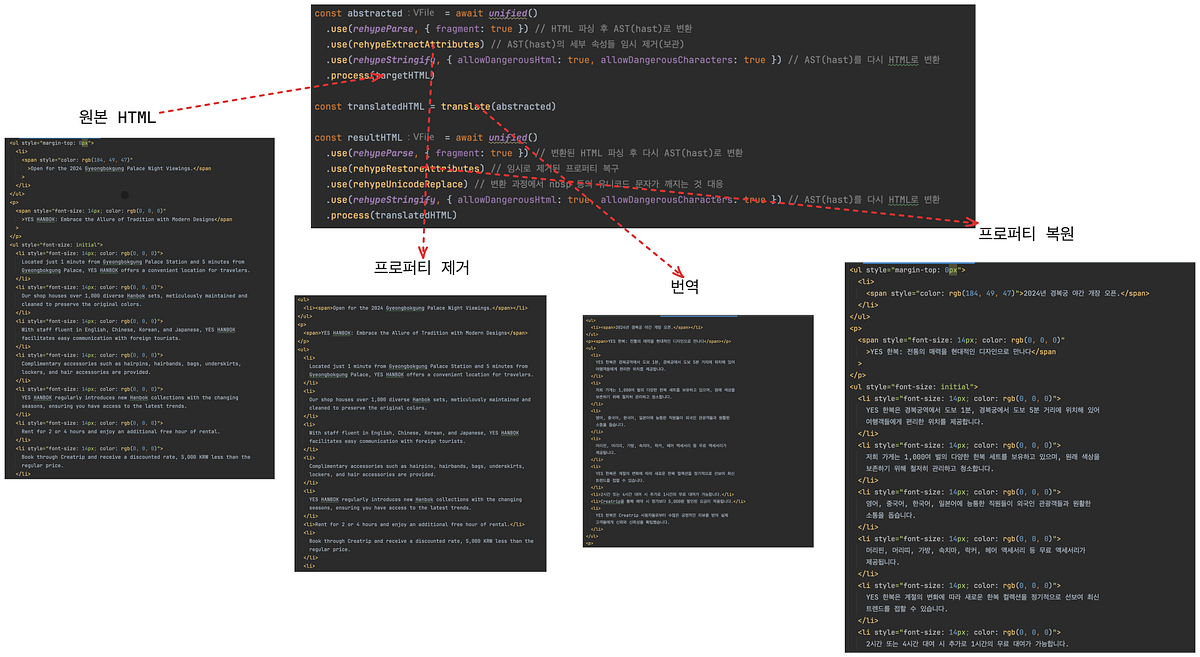
HTML 번역 전에 unified와 rehype로 속성을 분리해 LLM 입력을 최소화했습니다. 그 결과 토큰을 약 40% 줄이고 번역 오류 위험도 낮췄습니다.