

Kafka와 ETL을 활용해 대용량 데이터 마이그레이션하기
대용량 이미지 데이터를 MySQL에서 MongoDB로 마이그레이션한 경험을 공유했습니다. Kafka, ETL, CDC를 조합해 동기화와 샤딩 최적화, 안정적 전환까지 진행했습니다.
#Kafka#ETL
5900
새로운 기술 블로그가 추가되었어요
대용량 이미지 데이터를 MySQL에서 MongoDB로 마이그레이션한 경험을 공유했습니다. Kafka, ETL, CDC를 조합해 동기화와 샤딩 최적화, 안정적 전환까지 진행했습니다.

무신사 WMS 리팩토링 과정에서 통합 테스트를 활용한 사례를 소개했습니다. Testcontainers와 Database Rider로 기능 보장과 빠른 검증을 함께 잡았습니다.

Aurora MySQL의 밸런싱 편중과 RDS Proxy의 운영·비용 제약을 해결하기 위해 MaxScale 전환을 검토하고 적용했습니다. Autoscaling과 failover까지 고려한 자동화 구성으로 CPU와 connection 분산을 안정화했습니다.

광고팀 MySQL 장애의 원인을 추천 API와 광고 서버 간 직접 호출 구조에서 찾았습니다. Kafka 토픽 발행으로 비동기화해 MySQL 부하를 줄이는 방향을 다뤘습니다.


autocommit 비활성화와 MVCC Snapshot 유지로 Master DB 데이터가 간헐적으로 조회되지 않은 원인을 분석했습니다. 외부 조회 메서드에 읽기 전용 트랜잭션을 적용하고 COMMIT 경로를 점검해 해결했습니다.

주문서 진입 시 발생하던 상품권 점유 인증 조회 쿼리의 병목을 분석하고 개선했습니다. 서브쿼리를 제거하고 결합 인덱스와 LIMIT 1을 적용해 조회 성능을 크게 높였습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
부스터스의 주문 수집부터 WMS 출고까지의 내부 플로우와 구축 배경을 정리한 글입니다. 주소 잘림과 중복 실행 이슈, 그리고 격리 수준을 활용한 정합성 방어를 다뤘습니다.
AWS Aurora/RDS와 DynamoDB를 GCP Cloud SQL for MySQL로 이전한 과정을 정리했습니다. 쿼리와 스키마 점검, 병렬 복제, binlog 설정으로 다운타임과 비용을 줄인 사례입니다.

LINE VOOM의 MySQL을 신규 IDC로 이전한 과정을 소개했습니다. 읽기 전용 모드와 AOP, Central Dogma로 정합성과 롤백 단순화를 확보했습니다.


상품 데이터 동기화와 변경 이력 추적을 위해 Debezium CDC를 AWS MSK Connect에 적용한 사례를 소개했습니다. Oracle과 MySQL 설정, 플러그인 생성, 커넥터 구성 및 운영 포인트를 함께 정리했습니다.
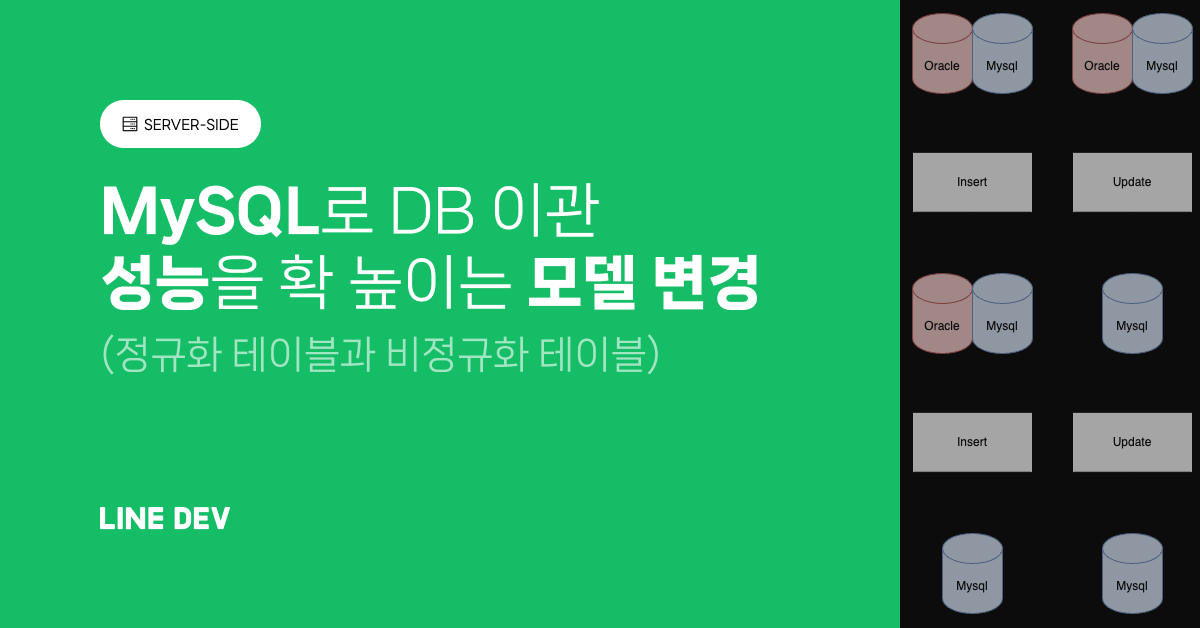
Oracle 주문 DB를 MySQL로 이관하면서 모델과 ID 채번 방식을 함께 재설계했습니다. 읽기·쓰기 성능을 개선하고 정합성과 동시성 문제를 단계적으로 해결했습니다.

5년간의 시행착오 끝에 사용자 피드백 도구 ABC User Feedback를 실제 서비스에 안착시킨 과정을 소개했습니다. 운영 구조와 책임 주체를 먼저 정리하고, 설치 편의성과 데이터 소유권을 핵심 원칙으로 발전시킨 사례입니다.
Transactional Outbox 패턴으로 DB 트랜잭션과 메시지 발행의 원자성을 보완하는 방법을 소개했습니다. 리디는 Polling Publisher와 락 조합, 지연 삭제로 Kafka 메시지 신뢰성과 운영 성능을 함께 개선했습니다.

MySQL 인덱스가 있어도 풀스캔이 더 유리해지는 손익분기점과, 인덱스 스캔 비효율 사례를 설명했습니다. 실행계획과 실제 IO를 비교해 복합 인덱스 조건을 어떻게 개선할지 정리했습니다.