
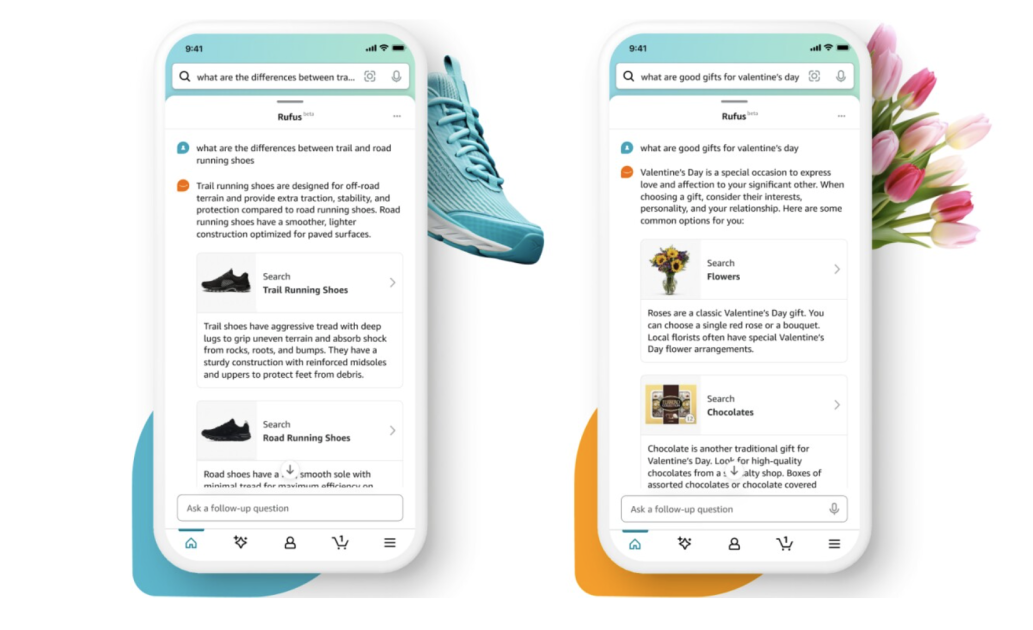

Amazon Bedrock을 이용해 Amazon Rufus 구현해보기
Amazon Bedrock과 AWS 서비스 조합으로 Rufus 같은 쇼핑 어시스턴트를 구현하는 방법을 소개했습니다. Tool 최적화, 컨텍스트 사전 로딩, prompt caching으로 응답 속도를 줄이는 방식을 설명했습니다.
#Amazon Bedrock#LLM
12100
Amazon Bedrock과 AWS 서비스 조합으로 Rufus 같은 쇼핑 어시스턴트를 구현하는 방법을 소개했습니다. Tool 최적화, 컨텍스트 사전 로딩, prompt caching으로 응답 속도를 줄이는 방식을 설명했습니다.

AI 코딩 어시스턴트의 시장 동향과 국내외 도입 사례, 모델·솔루션 비교를 한 번에 정리했습니다.파일럿 검증을 거쳐 성능, 보안, 비용을 함께 고려한 점진적 도입 전략을 제안했습니다.

OpenSearch Service의 AI Search Flow 빌더로 Semantic 검색과 멀티모달 RAG를 빠르게 구성하는 방법을 소개했습니다. Ingest/Search Pipeline과 템플릿, AI 제공업체 연동으로 미들웨어 없이 검색 기능을 확장하는 흐름을 설명했습니다.


Computer Use Agent의 개념과 활용 배경을 소개하고, AgentQ 논문과 구현을 직접 실행해보는 과정을 정리했습니다. MCTS와 DPO를 결합한 정책 학습 구조와 실습 절차도 함께 설명했습니다.

미저장 연락처의 관계를 예측하는 AI 기능 고도화 과정을 소개했습니다. 데이터 정제와 LLM 학습으로 정확도를 13% 이상 높였습니다.

AI 코딩 에이전트 5종의 실제 사용 경험을 바탕으로 강점과 한계를 비교했습니다. 반복 작업은 AI에 맡기고 개발자는 더 창의적인 업무에 집중하는 방향을 제안했습니다.

VLM은 쉬운 공간 관계 문제도 자주 틀리는 한계가 있습니다. 현업 적용 전 정확성과 취약점을 충분히 검토해야 했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

무신사는 스냅 이미지와 자연어를 활용한 AI 추천·검색 프로토타입을 AWS 기반으로 구현했습니다. 실제 데이터 평가에서 높은 정확도를 보였지만, 일부 이미지 조건에서는 한계도 확인했습니다.

프론트엔드 개발자가 바이브코딩을 통해 생산성 향상을 체감한 경험을 공유했습니다. 동시에 테스트 코드, 업무 분할, 프롬프트 설계, 도메인 지식의 필요성도 강조했습니다.
PDF의 좌표 중심 저장 구조와 객체 유형·읽기 순서 문제로 파싱이 어려운 이유를 설명했습니다. PDFium 기반 텍스트·TOC·이미지 추출과 OCR·LLM 후처리 조합을 소개했습니다.
시맨틱 캐싱을 도입해 채팅 AI 메시지 추천의 LLM 호출 비용을 크게 줄인 사례를 소개했습니다. 오프라인과 온라인 검증을 통해 약 25% HIT 비율과 연간 2억 원대 절감 효과를 확인했습니다.

데이터 파이프라인 운영에서 노이즈 알림과 반복 대응으로 인한 피로를 줄이기 위해 AI 활용 방안을 소개했습니다. 로그 전처리, 노이즈 분류, AI Assistant 적용 사례를 중심으로 장애 대응 자동화를 다뤘습니다.

AR 언어모델의 한계를 보완하기 위해 Diffusion 기반 언어생성 접근을 소개했습니다. 학습과 추론 절차, 성능 강점과 한계까지 논문 관점에서 정리했습니다.

AI 발전으로 디지털 마케팅 전 과정을 통합 자동화할 가능성을 소개했습니다. 특히 광고 소재는 레이아웃 최적화와 배경 생성이 핵심이라고 설명했습니다.