

Open LLM Leaderboard 찍먹 후기
Open LLM Leaderboard 찍먹 후기
Huggingface Open LLM Leaderboard와 모델 병합 사례를 소개하는 후기 글입니다. CarbonVillain과 KF-DeBERTa를 통해 팀의 프로젝트도 함께 살펴볼 수 있습니다.
#LLM#NLP
2500
새로운 기술 블로그가 추가되었어요
Huggingface Open LLM Leaderboard와 모델 병합 사례를 소개하는 후기 글입니다. CarbonVillain과 KF-DeBERTa를 통해 팀의 프로젝트도 함께 살펴볼 수 있습니다.
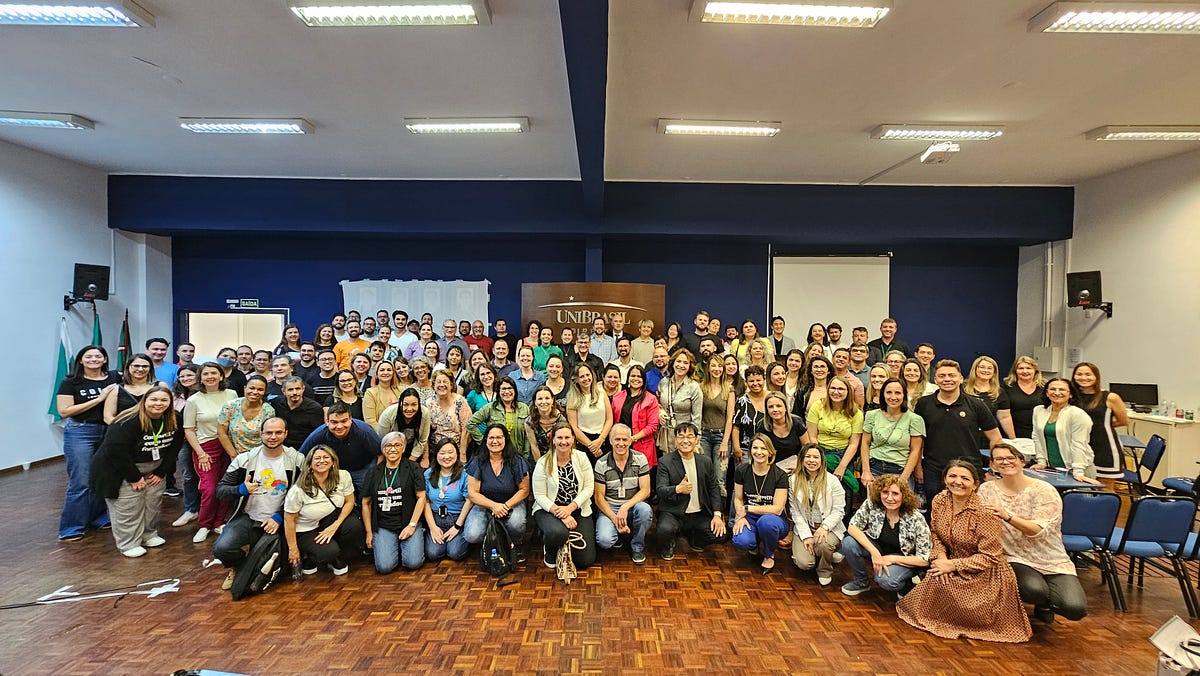
브라질 파라나주에서 Quizium을 100명의 교사들에게 소개하고 시연했습니다. 현지 피드백을 바탕으로 제품 개선과 글로벌 교육 혁신 방향을 점검했습니다.

INTERSPEECH 2023 참가와 포스터 발표 경험을 중심으로 음성 언어 처리 연구 동향을 정리했습니다. 데이터 부족, 음성 모델 활용, 벤치마크의 중요성을 다시 확인했습니다.
NAVER GLACE AI 개발팀의 서비스 적용 사례와 운영 체계를 소개했습니다. 또한 PlaceLM을 중심으로 태그 추출과 서빙 효율 개선 방향을 설명했습니다.


ACL 2023의 NLP·LLM 논문 18편을 핵심 방법과 실험 결과 중심으로 리뷰했습니다. CoT, 인스트럭션 튜닝, 데이터 생성·평가, 다국어 일반화의 한계를 함께 살펴봤습니다.
프롬프트 엔지니어링을 AI를 잘 쓰기 위한 핵심 기술로 설명하며 주요 기법과 가이드라인을 정리했습니다. 또한 프롬프트 마켓과 적대적 프롬프팅의 가능성과 우려도 함께 살펴보았습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

EMNLP 2022의 NLP 논문 14편을 대화, 검색, 생성, 평가, 데이터셋 관점에서 리뷰했습니다. 프롬프트·LLM·멀티모달 학습의 성과와 개인정보, 비용, 데이터 품질 이슈를 함께 다뤘습니다.
네이버 GLACE AI 개발팀이 서비스에 적용하는 NLP·CV 모델과 전용 LLM PlaceLM을 소개했습니다. 또한 데이터 버전 관리, 모니터링, 무중단 배포 등 운영 체계도 함께 다뤘습니다.

AI 워크로드는 학습 단계와 데이터 특성에 따라 스토리지 요구사항이 달라집니다. 고성능과 확장성을 함께 고려해 블록, 파일, 오브젝트 스토리지를 비교하고 하이브리드 구성을 제안했습니다.
상위·하위 인텐트를 함께 추론하는 챗봇을 위해 MTL 기반 PLE 모델과 CurricularFace loss를 적용했습니다.\n기존 앙상블보다 성능과 관리 효율을 함께 개선한 사례를 소개했습니다.
자연어처리의 토픽 모델링을 개인화 추천에 적용하는 방식을 소개했습니다. 사용자 행동 데이터를 바탕으로 관심 주제를 추출해 맞춤형 추천을 구성하는 개념을 설명했습니다.

지속 학습에서 발생하는 Catastrophic Forgetting 문제와 주요 해결 방법을 분류해 소개했습니다. 정규화, 메모리 재학습, 구조 확장, 지식 증류의 특성을 설명했습니다.

ACL 2022의 NLP 연구 12편을 프롬프트, 문장 표현, 대화, 멀티모달 평가 관점에서 리뷰했습니다. 대조 학습과 평가 체계 개선 등 주요 제안과 실험 결과를 정리했습니다.

외부 데이터 제한 환경에서 BART 기반 한국어 대화요약 모델을 개선한 경진대회 사례를 공유했습니다. 사전학습·R3F·강화학습을 조합해 ROUGE-L 기준 성능을 높이고 본선 1위를 달성했습니다.