


데이터사이언스팀이 예측모델을 개발하고 운영하는 방법을 소개합니다.
데이터사이언스팀의 예측모델 개발·운영 구조와 MLOPS 기반 서빙 체계를 소개했습니다. 또한 배포 후 대응, 성능 분석, Leakage 주의 등 실무에서 배운 점을 정리했습니다.
#ML#MLOps
2900
새로운 기술 블로그가 추가되었어요
데이터사이언스팀의 예측모델 개발·운영 구조와 MLOPS 기반 서빙 체계를 소개했습니다. 또한 배포 후 대응, 성능 분석, Leakage 주의 등 실무에서 배운 점을 정리했습니다.

카카오페이 MLOps 플랫폼에서 ML 모델 학습 파이프라인 설계 사례를 공유했습니다. 플랫폼 관점에서 모델 학습 흐름을 정리한 내용입니다.

리디 데이터사이언스팀이 기존 시스템을 활용해 머신러닝 파이프라인을 구축한 사례를 소개했습니다. 학습, 배포, A/B 테스트, 모니터링까지 유기적으로 연결해 운영 효율을 높였습니다.
도구 분산으로 커진 ML 실험 환경의 복잡성을 해결하기 위해 Kubeflow를 도입했습니다. Elyra, S3·IRSA, SealedSecrets 기반의 운영 설정과 보안 관리 팁을 공유합니다.

쿠브플로우 도입 배경과 세이지메이커 비교, 그리고 운영을 위한 초기 설정 팁을 정리했습니다. 데이터 사이언티스트 친화적인 MLOps 환경을 만들기 위한 실무 사례를 소개했습니다.

Kubernetes 기반 MLOps 환경에서 GPU 자원 운영 부담을 줄이기 위한 기반을 설계했습니다. Karpenter와 NVDP로 GPU 노드의 자동 생성·회수 흐름을 구성했습니다.

컬리의 MLOps 구축 초기에 GPU 노드 자동화와 Karpenter 도입 과정을 소개했습니다. NVDP, affinity, consolidation 이슈까지 포함해 운영 포인트를 정리했습니다.


TFX 커스텀 컴포넌트로 신규 데이터부터 학습·모델 등록까지의 파이프라인을 구성했습니다. Apache Beam과 사내 레지스트리를 연동하는 구현·운영 주의점을 설명합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

EHR 기반 의료 AI의 문제 정의부터 일반화 평가까지 5단계 개발 파이프라인을 소개했습니다. 보정·불확실성 추정과 임상 환경의 엄격한 검증 필요성을 강조했습니다.

버즈빌 전문연구요원의 백엔드·광고 서버·추천 시스템 업무 경험을 소개했습니다. 자율적 업무 문화와 클라우드·ML·MLOps 학습 활동을 공유합니다.
BentoML로 딥러닝 모델을 API 형태로 서빙한 경험과 패키징, 도커라이징 과정을 정리했습니다.\nSwagger UI 제공과 성능 개선, 운영 편의성 측면의 장단점도 함께 공유했습니다.
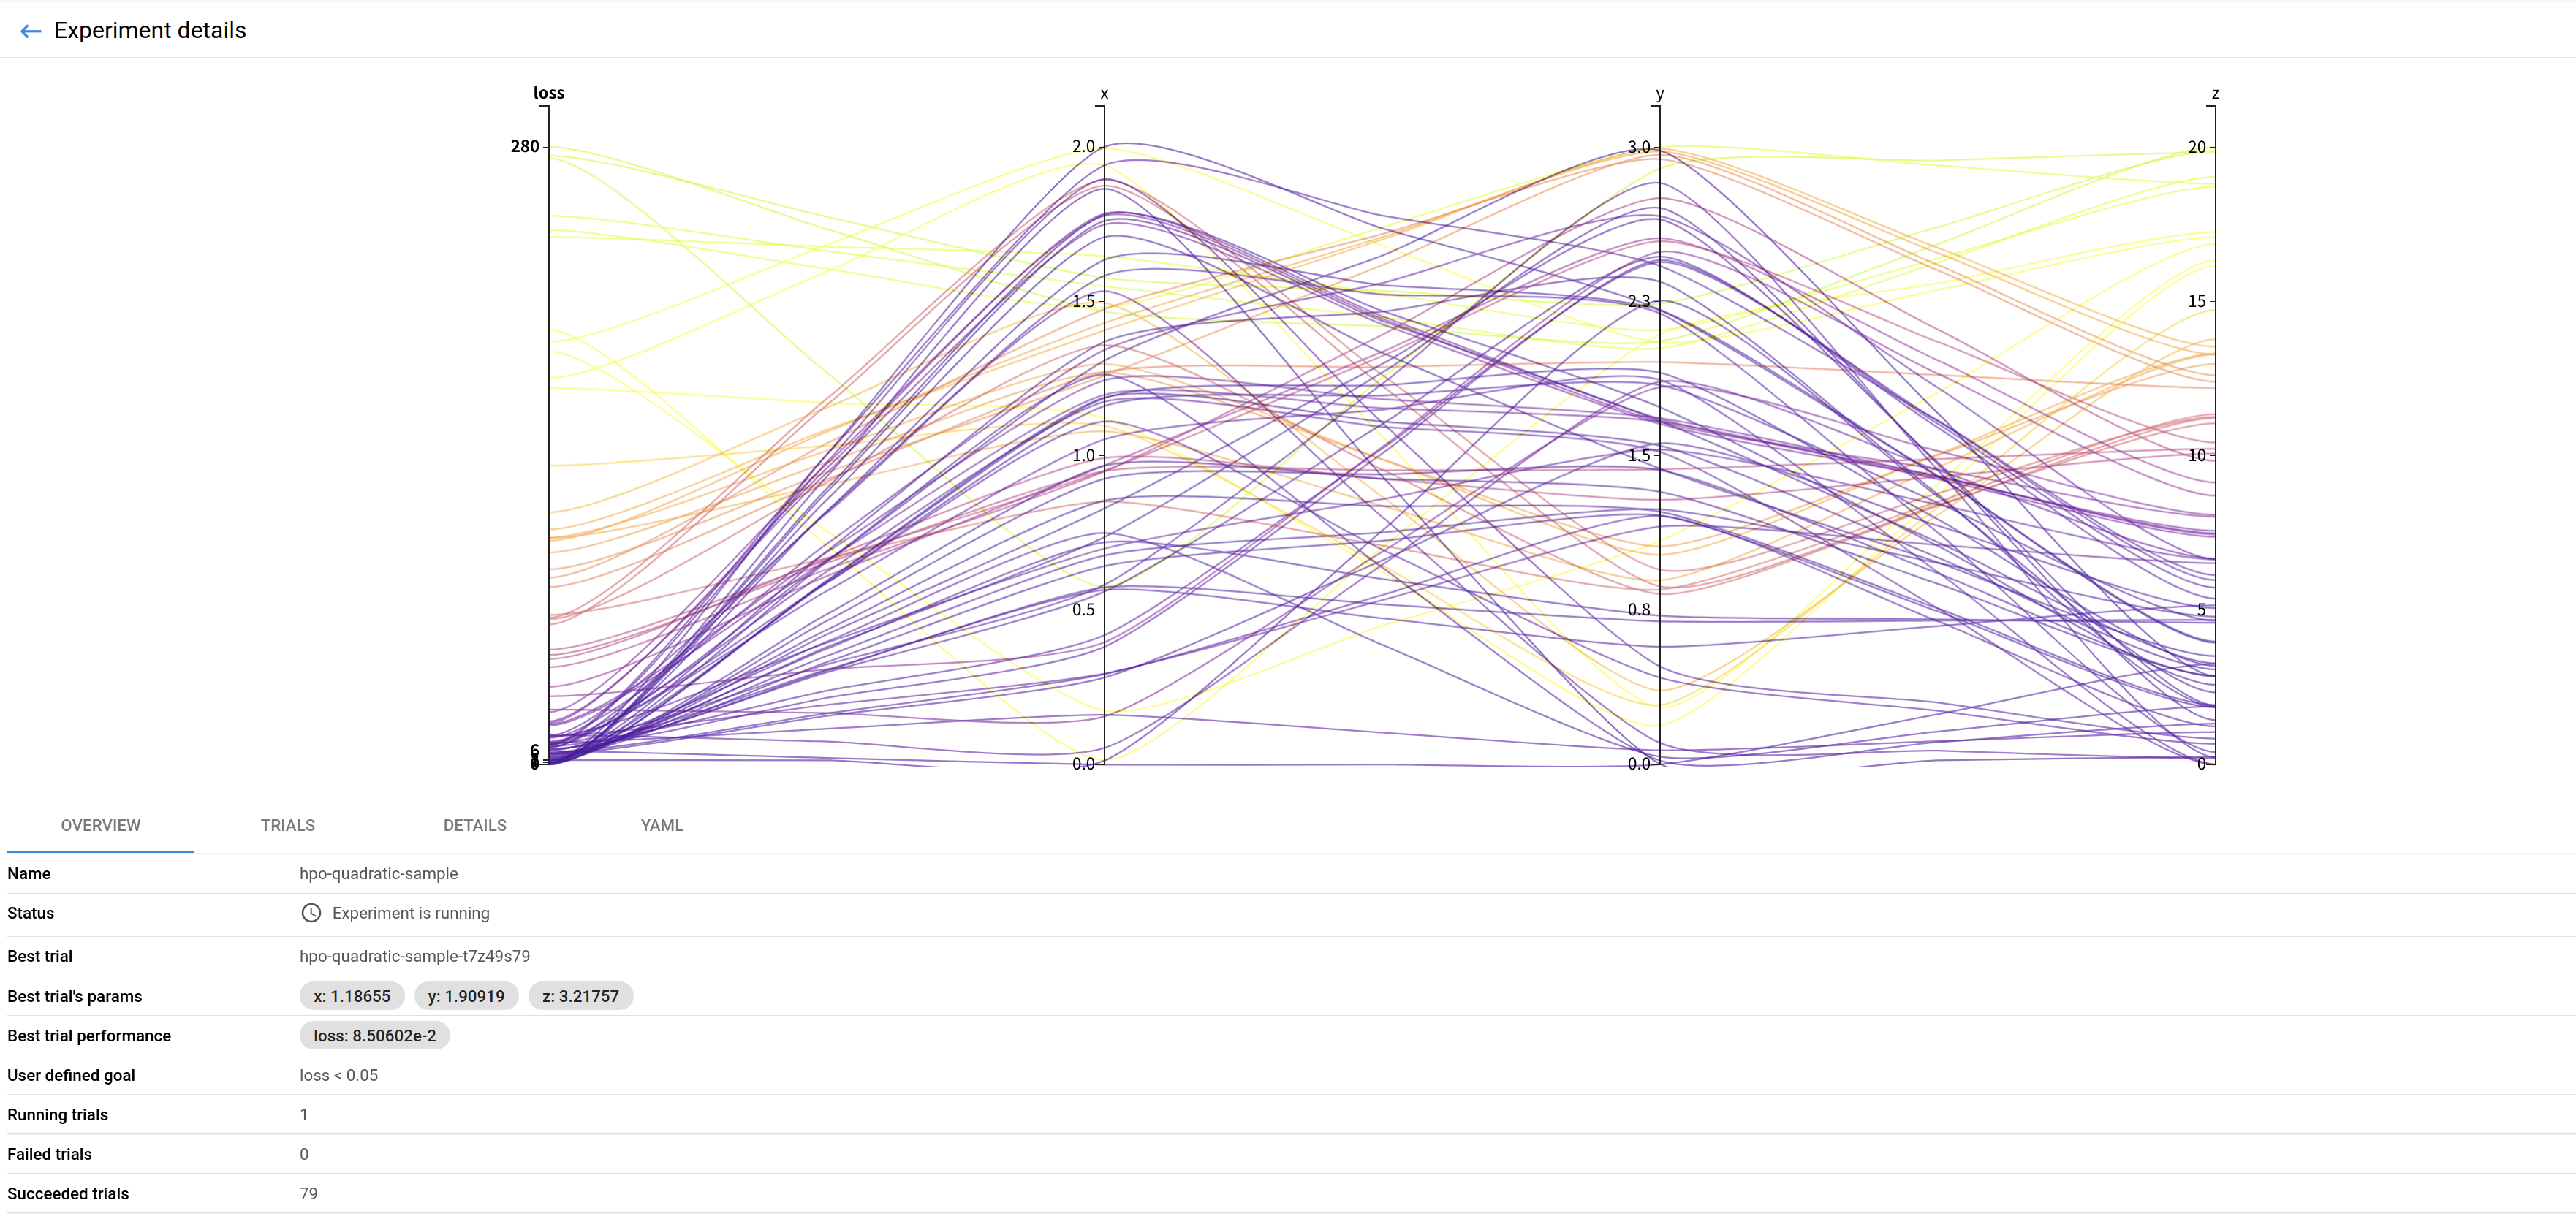
Katib Experiment의 잘못된 요청이 멈춘 상태로 보이는 문제를 분석했습니다. CLI 안전장치와 조기 검증 로직을 오픈소스에 기여했습니다.