

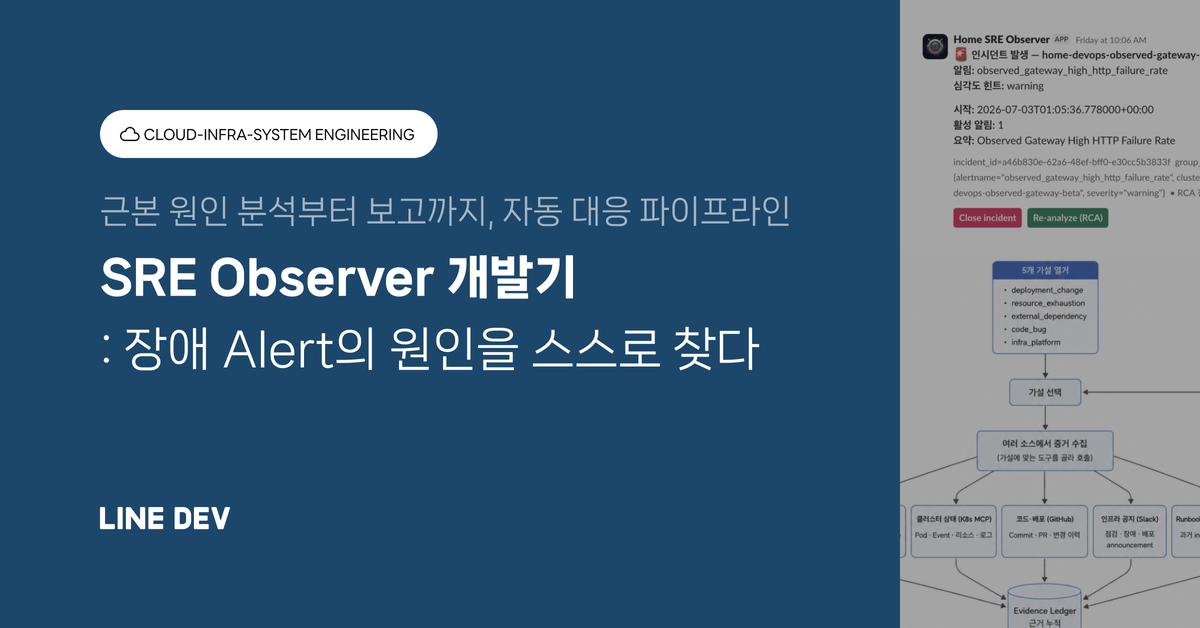
장애 Alert의 원인을 스스로 찾다: SRE Observer 개발기
Alert를 자동으로 묶고 근본 원인까지 분석하는 SRE Observer 개발 과정을 소개했습니다. 근거 기반 가드레일과 승인 경계로 과신을 막고 대응 자동화를 설계했습니다.
#SRE#LLM
4500
새로운 기술 블로그가 추가되었어요
Alert를 자동으로 묶고 근본 원인까지 분석하는 SRE Observer 개발 과정을 소개했습니다. 근거 기반 가드레일과 승인 경계로 과신을 막고 대응 자동화를 설계했습니다.


Nitro V6에서 EC2 Connection Tracking 유휴 타임아웃 기본값이 350초로 바뀐 내용을 정리했습니다. TCP keepalive와 타임아웃 정렬로 silent drop과 연결 실패를 예방하는 방법을 설명했습니다.

EC2 기반 Kafka Streams를 k8s와 KEDA로 옮겨 consumer lag 중심 스케일링을 설계했습니다. 그 결과 트래픽에 맞는 운영과 80% 이상 비용 절감을 달성했습니다.

아임웹은 ALB 한도와 ECS Target Group 제한을 넘기 위해 VPC Lattice와 Kong을 조합해 서비스 네트워크를 재설계했습니다. 서비스 통합으로 Lattice 고정비를 82% 절감하고, 무중단 이관과 배포 유실 0건을 확인했습니다.
홈랩 Kubernetes에서 ArgoCD와 GitLab Self-Managed를 연동해 GitOps를 구축하는 과정을 실습했습니다. 접속, 인증, 저장소 등록, Kustomize 전환에서 막히는 지점과 해결책도 정리했습니다.
수천 명 동시 접속 행사 게임을 WebSocket 없이 Redis와 SSE 중심으로 단순화해 구현했습니다. 리허설에서 드러난 저사양 전광판 문제는 렌더링 방식을 바꾸고 영상은 하드코딩으로 대응했습니다.
생성형 AI는 클라우드 엔지니어의 업무를 빠르게 만들지만, 요구사항 해석과 트레이드오프 판단은 여전히 중요합니다. AI가 제시한 아키텍처와 코드를 검증하는 기본기와 시스템 전체를 보는 시야가 더 중요해졌습니다.


개발과 운영 전반에 AI를 적용하는 kt cloud의 사례를 소개했습니다. Observability, 개발환경 자동화, PR 리뷰 자동화와 장애 대응 전략을 함께 다뤘습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.


@Scheduled 기반 배치가 Pod 확장 시 중복 실행과 유실 문제를 드러내자, 트리거를 애플리케이션 밖으로 분리했습니다. 실행은 선점과 체크포인트로 나눠 맡겨 여러 Pod가 작업을 분담하도록 전환했습니다.

kt cloud가 Chkk로 대규모 Kubernetes 클러스터의 업그레이드 영향과 취약점을 사전 검증한 사례를 다뤘습니다. 수작업 분석을 줄이고 부서 간 협업으로 무장애 변경 관리 체계를 강화했습니다.

kt cloud summit 2026 행사와 주요 세션 구성을 안내하는 글입니다. AI 인프라, 클라우드 플랫폼, DR, 보안 등 AX 운영 핵심 기술과 사례를 소개합니다.

LLM 서빙에서는 단순히 모델을 띄우는 것보다, 지표를 잘 설계하고 원인을 빠르게 추적하는 운영이 중요했습니다. Prefix Cache, finish_reason, KV Cache 같은 신호를 활용해 타임아웃과 처리량 문제를 해결했습니다.
ALB 한도와 ECS Target Group 제한을 넘기 위해 Kong과 VPC Lattice로 서비스 네트워크를 재설계했습니다.\n서비스 통합과 GitOps 제어로 고정비를 82% 줄이고, 이관과 배포 편입도 무중단으로 유지했습니다.
첫 사내 기술 콘퍼런스 우아한테크데이의 기획과 운영, 설문 결과를 정리했습니다.\n조직 간 기술 공유와 AI 활용 경험을 나누며 사내 커뮤니케이션을 넓힌 사례였습니다.