

Vector를 활용해 멀티 CDN 로그 및 트래픽 관리하기
Vector를 활용해 멀티 CDN 로그와 트래픽 모니터링 체계를 통합한 사례를 다뤘습니다. 로그 정규화, 메트릭 변환, 버퍼링과 모니터링까지 쿠버네티스 기반으로 고도화했습니다.
#Vector#CDN
2900
새로운 기술 블로그가 추가되었어요
Vector를 활용해 멀티 CDN 로그와 트래픽 모니터링 체계를 통합한 사례를 다뤘습니다. 로그 정규화, 메트릭 변환, 버퍼링과 모니터링까지 쿠버네티스 기반으로 고도화했습니다.
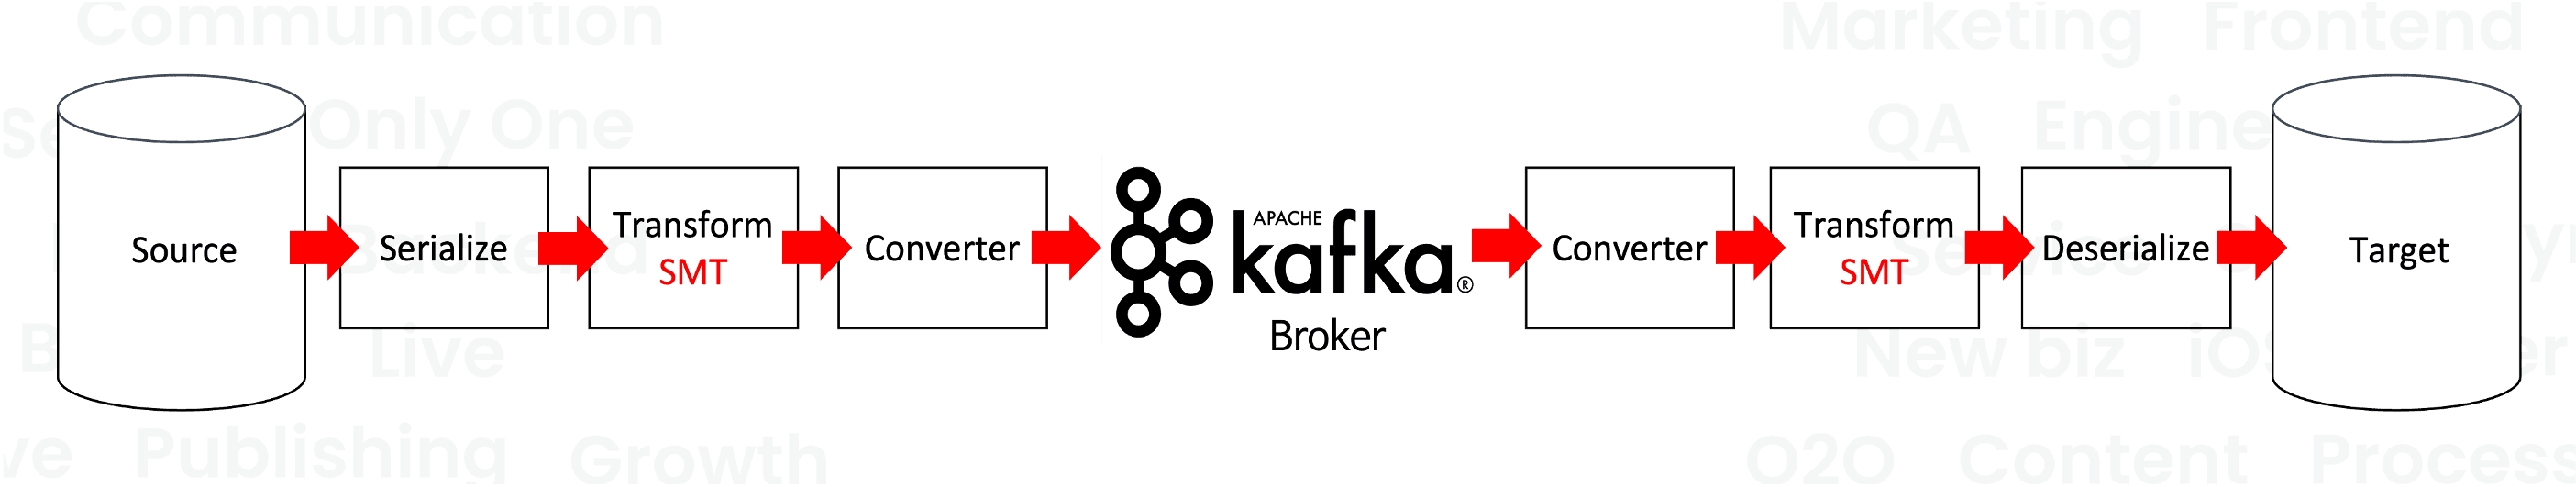

AWS MSK Connect와 Kafka 기반 CDC 운영 전략을 정리한 글입니다. 장애 대응, 데이터 경량화, DLQ, 모니터링 설정까지 실무 운영 포인트를 소개했습니다.
신규 재고 시스템을 구축하며 Oracle DB 집중 트래픽, 동시성, 연동 안정성 문제를 해결한 과정을 소개했습니다. 분산 락, Kafka, Reactive Programming, CircuitBreaker와 모니터링 적용 사례를 정리했습니다.


대량 트래픽과 긴 지연 API를 처리하기 위해 Kafka, Redis, SSE 기반 비동기 메시지 통신 구조로 전환했습니다.\n동기 의존성을 줄이고 Scale Out 환경에서도 Refresh 결과를 안정적으로 전달하는 설계를 적용했습니다.
무신사 테크가 Databricks Data+AI Summit 2023 참석 후기를 공유했습니다. 생성형 AI, 데이터 플랫폼, 재해복구 등 실무 인사이트를 정리했습니다.
Redis Worker의 한계를 보완하기 위해 RabbitMQ를 도입한 사례를 소개했습니다. 행사성 트래픽과 대량 발급 처리에서 안정성과 운영 편의성을 개선했습니다.
SK플래닛의 클라우드 기반 검색 시스템 구조와 주요 기능을 소개했습니다. 또한 ChatGPT 이후 대화형 검색으로의 확장 가능성을 함께 살펴봤습니다.

준실시간 수요예측을 위해 Apache Beam 기반 GCP Dataflow 파이프라인을 도입한 배경과 동작 구조를 설명했습니다. Flex 템플릿·CI/CD 배포 과정과 스트리밍, 권한, 비용 관련 운영 팁을 정리했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
컬리의 준실시간 수요 예측 모델을 위해 Dataflow 파이프라인을 도입한 배경과 전체 동작 방식을 설명했습니다. Beam, Flex 템플릿, CI/CD, 권한 설정 등 실무 적용 포인트도 함께 정리했습니다.
ksqlDB를 Kafka Streams 기반의 SQL 엔진으로 소개하며 동작 원리와 아키텍처를 설명했습니다. 또한 Push Query와 Pull Query, stateful 처리와 리밸런싱 개념을 함께 정리했습니다.

Debezium connector 재시작 때 오래된 binlog를 다시 읽으며 DB CPU가 급등한 원인을 분석했습니다. heartbeat.interval.ms를 적용해 상태 기록 주기를 보강하고 문제를 해결했습니다.
Testcontainers로 Kafka·PostgreSQL·Spring 애플리케이션을 함께 구동해 사용자 시나리오 통합 테스트를 구성했습니다.\nGitHub Actions 트리거로 배포 이미지 생성 뒤 테스트를 실행해 QA 부담을 줄이는 방식을 소개합니다.
Testcontainers로 Kafka, PostgreSQL, Spring 앱을 함께 띄워 실제 사용자 흐름에 가까운 통합테스트를 구성했습니다. 서버 간 제약 불일치로 생길 수 있는 버그를 QA 전에 조기에 찾고, 배포 후 자동 검증까지 연결했습니다.

비동기 메시지 처리와 Kafka 중심의 분산 라이브채팅 아키텍처를 설계했습니다. k6 기반 성능 테스트로 브로커와 로드밸런싱 이슈를 개선했습니다.