


실시간 추천 서비스를 위해 메시지 큐잉 도입하기(with Redis Streams)
LINE VOOM 실시간 추천을 위해 Go 채널 대신 Redis Streams 기반 큐잉 구조를 도입한 과정을 소개했습니다. 클러스터 메모리 집중 문제를 쿠폰 수집가 문제로 풀고, 운영 스위치와 모니터링 API까지 마련했습니다.
#Redis Streams#Kafka
5400
새로운 기술 블로그가 추가되었어요
LINE VOOM 실시간 추천을 위해 Go 채널 대신 Redis Streams 기반 큐잉 구조를 도입한 과정을 소개했습니다. 클러스터 메모리 집중 문제를 쿠폰 수집가 문제로 풀고, 운영 스위치와 모니터링 API까지 마련했습니다.
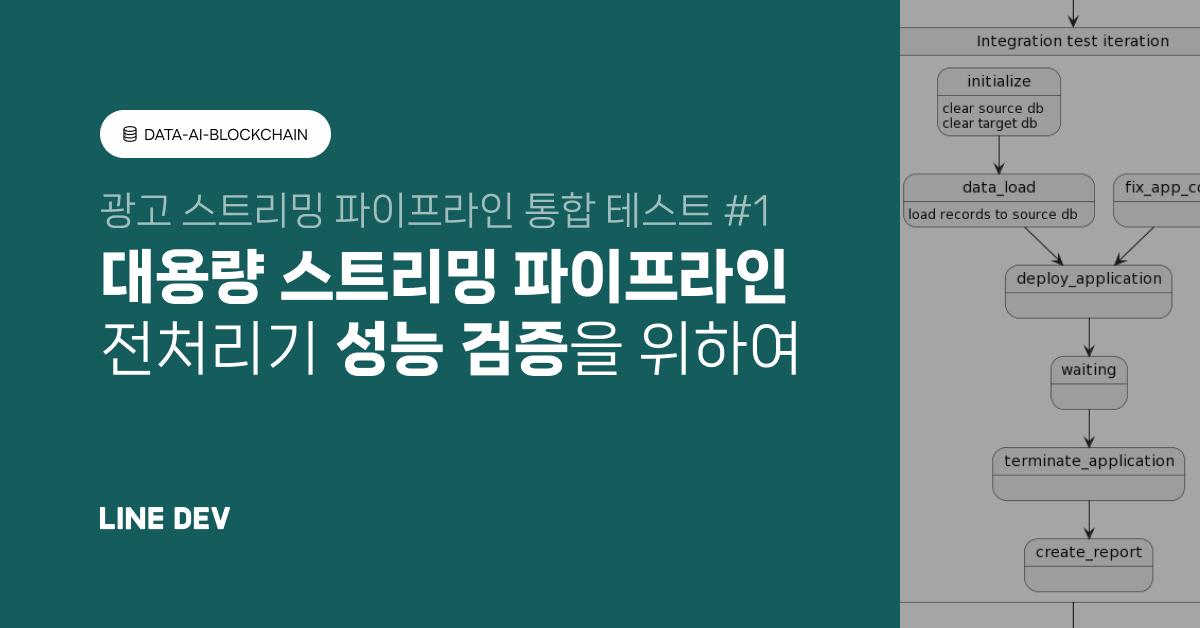
대용량 스트리밍 파이프라인의 성능과 장애 대응을 실제 데이터로 검증해야 하는 배경을 설명했습니다. 쿠버네티스 네이티브 워크플로를 이용한 반복 실험 자동화 방식을 Tekton과 Litmus로 풀어갈 계획입니다.


상품 데이터 동기화와 변경 이력 추적을 위해 Debezium CDC를 AWS MSK Connect에 적용한 사례를 소개했습니다. Oracle과 MySQL 설정, 플러그인 생성, 커넥터 구성 및 운영 포인트를 함께 정리했습니다.
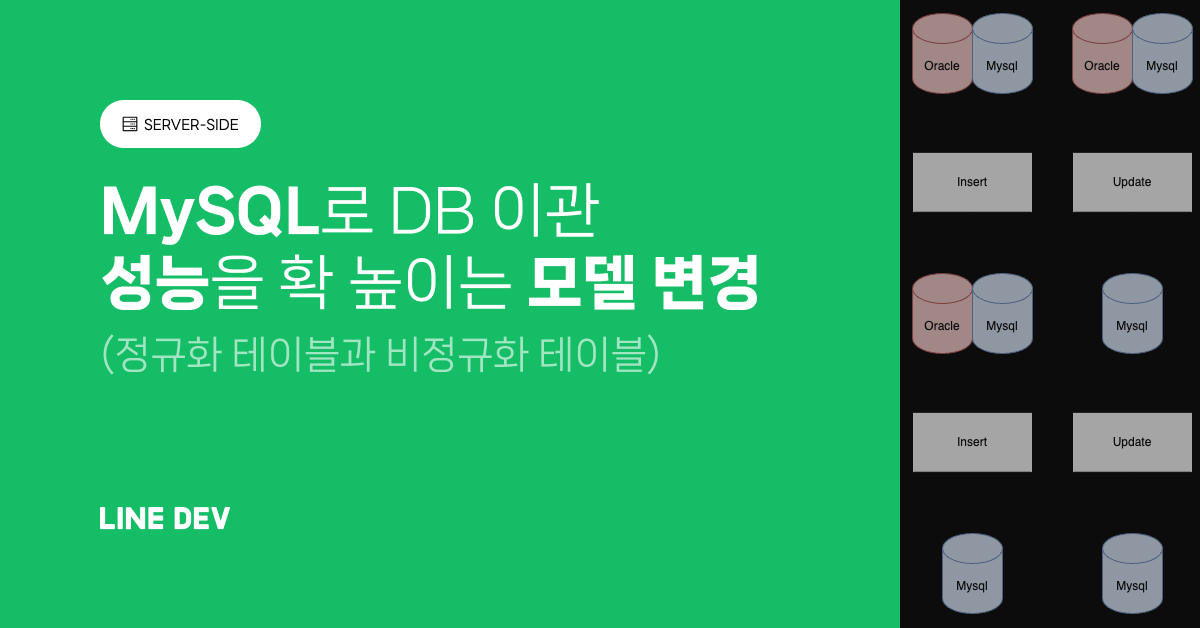
Oracle 주문 DB를 MySQL로 이관하면서 모델과 ID 채번 방식을 함께 재설계했습니다. 읽기·쓰기 성능을 개선하고 정합성과 동시성 문제를 단계적으로 해결했습니다.

FY23 회고 블로그 릴레이를 소개하는 안내 글입니다. 총 9편의 연재 일정과 각 글의 주제를 함께 안내했습니다.
Transactional Outbox 패턴으로 DB 트랜잭션과 메시지 발행의 원자성을 보완하는 방법을 소개했습니다. 리디는 Polling Publisher와 락 조합, 지연 삭제로 Kafka 메시지 신뢰성과 운영 성능을 함께 개선했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

대용량 JSON 처리에서 발생한 OOM과 세션 제한 문제를 정리했습니다. 요청 지연, Kubernetes Job 분리, HTTP 스트리밍과 MongoDB 최적화로 안정성을 높였습니다.
엑셀 데이터 추출 기능이 느려지고 서버 부하가 커지는 문제를 개선한 경험을 공유했습니다. 비동기 이벤트와 Spring Batch Partitioning으로 처리 분리와 재다운로드 구조를 구성했습니다.

외부셀러의 동기식 API 구조를 비동기 이벤트 기반으로 분리해 내부 시스템 보호 방안을 소개했습니다. AWS MSK와 partition key, retry 로직으로 스파이크 트래픽 대응과 순서 보장을 다뤘습니다.

팀 스터디의 1년 운영 경험을 Season 1~3로 나눠 회고했습니다.\n자유 주제와 도서 스터디, 토킹 어바웃으로 깊이와 지속성을 높인 점을 정리했습니다.
ksqlDB를 이용해 카프카 이벤트로부터 실시간 ML 피쳐를 계산하는 방법을 소개했습니다. 변환·필터링·윈도우 집계를 SQL만으로 구성하고, 제약과 주의점도 정리했습니다.

MQTT의 기본 개념과 QoS, 세션, 요청/응답 패턴을 정리하고 POS 연동 적용 가능성을 살펴보았습니다. 또한 NestJS와 Amazon MQ로 테스트해 재연결 시 메시지 수신과 전달 보장 가능성을 확인했습니다.

리디가 Braze 기반 CRM 캠페인을 통해 고객 세분화와 맞춤형 알림 실험을 진행한 사례를 공유했습니다. 수동 테스트에서 검증한 뒤 Athena, replica DB, Kafka로 자동화하고 빈도 제한과 단계적 배포로 운영 안정성도 확보했습니다.

태깅 파이프라인을 원본 저장, 로직 분리, write buffer로 재설계해 업데이트 부하를 줄였습니다. 운영툴 통합과 수동 태그 보존으로 관리성과 안정성도 함께 높였습니다.