
메모리 모델 입문 - Sequential Consistency와 Total Store Order 이해하기
메모리 모델 입문 관점에서 SC와 TSO를 비교하며 x86에서 재정렬이 발생하는 이유를 설명했습니다. 또한 저장 버퍼와 바이패싱을 통해 실제 동작을 형식화하고, DRF 프로그램과 원자적 연산의 관계도 정리했습니다.
#메모리 모델#Sequential Consistency
4000
메모리 모델 입문 관점에서 SC와 TSO를 비교하며 x86에서 재정렬이 발생하는 이유를 설명했습니다. 또한 저장 버퍼와 바이패싱을 통해 실제 동작을 형식화하고, DRF 프로그램과 원자적 연산의 관계도 정리했습니다.
컬리의 후기 이미지 흐림 판별 개선 과정을 정리했습니다. 딥러닝 실험의 한계를 확인한 뒤 라플라시안 필터와 표준편차 기반 방식으로 정확도를 높였습니다.
Azar iOS 팀이 Periphery로 Swift 프로젝트의 미사용 코드를 찾고 공유하는 체계를 만들었습니다. GitHub Actions와 CSV→HTML 변환, artifact 업로드로 주기적 운영도 함께 구성했습니다.
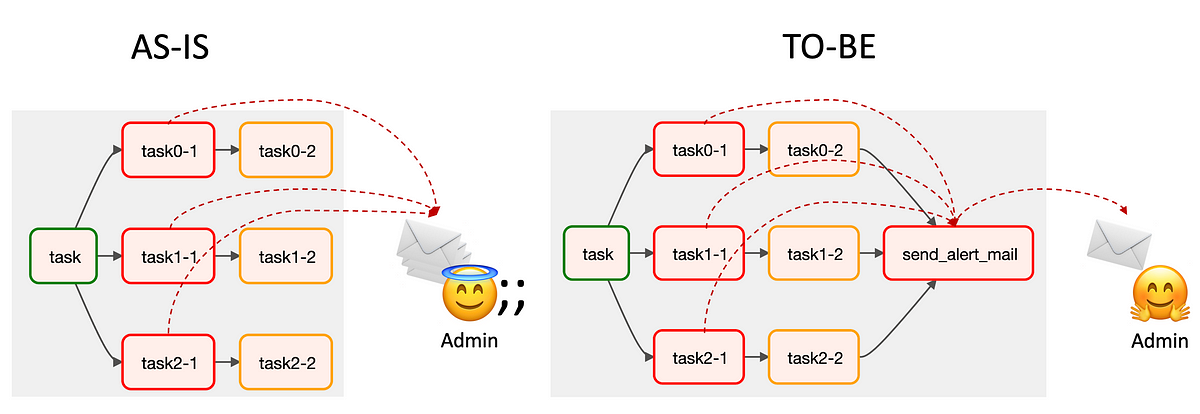
Airflow에서 동일 원인으로 반복 발송되는 Task 실패 알림을 하나로 통합하는 방법을 다루었습니다. DAG run의 Task Instance와 로그를 활용해 중복 메일 노이즈를 줄이는 구현을 소개했습니다.

GPT-4와 ada embeddings로 리뷰 기반 맛집 추천 서비스를 구현한 과정을 정리한 글입니다. 검색 정확도 문제를 겪으며 벡터 검색과 리뷰 데이터의 한계도 함께 살펴보았습니다.

원티드랩의 데이터 마트 설계 과정을 ERD 작성부터 운영 규칙 정립까지 정리했습니다. BigQuery와 Airflow를 활용해 확장성과 품질을 높인 운영 방식도 소개했습니다.


요기요는 MSA 환경에서 분산된 데이터를 통합하기 위해 Confluent Schema Registry를 도입했습니다. SubjectNameStrategy 3종과 multiple type event 적용 이슈를 Pilot 경험을 바탕으로 정리했습니다.
한국어 음성 4건으로 VITO·Clova·Google STT 전사 결과를 CER로 비교했습니다. VITO API가 평균 CER 6.32%로 가장 낮았으며, 제한된 샘플 기반 결과임을 함께 언급했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

MySQL 버전 업그레이드 시 SSL/TLS 지원 버전과 클라이언트 호환성을 꼭 확인해야 한다고 설명했습니다. 8.0.28에서 TLSv1.0, 1.1이 제거되며 발생하는 핸드셰이크 오류와 조회 방법을 다뤘습니다.

Dash를 도입해 데이터 조회, 가공, 렌더링을 역할별로 분리하고 연결하는 구조를 만들었습니다. 또한 Mixin과 압축을 활용해 유지보수성과 데이터 전송 효율을 개선했습니다.

QA 리소스 부족과 단말 한계를 보완하기 위해 Appium 자동화와 AWS Device Farm을 활용한 사례를 소개했습니다. 로컬 구성부터 가상환경 실행, 로그·영상 수집까지의 과정과 시행착오를 정리했습니다.

베이즈 정리의 기본 개념을 조건부 확률에서부터 차근차근 설명했습니다. 동전 던지기 예시와 수치해석, MCMC, PyMC로 사후분포를 추정하는 과정을 다뤘습니다.

ML 백엔드에서 Python의 느린 실행 속도를 줄이기 위한 최적화 팁을 공유했습니다. 특히 GC, list, numpy 같은 요소가 응답시간에 미치는 영향을 사례와 함께 설명했습니다.


생성형 AI가 데이터 사이언스의 반복 분석과 리포팅을 빠르게 자동화할 가능성을 정리했습니다. 이에 맞춰 조직과 개인이 도메인 이해와 문제 해결 역량을 강화해야 한다고 보았습니다.