

웹 워커를 통해 이미지 색상 수집기 성능 개선하기
웹 워커를 통해 이미지 색상 수집기 성능 개선하기
Canvas 이미지의 RGBA 배열에서 고유 색상을 추출하는 작업을 웹 워커로 분리했습니다. 다중 워커로 작업을 나눠 메인 스레드 블로킹과 UI 대기시간을 줄였습니다.
#Canvas#Web Worker
2100
새로운 기술 블로그가 추가되었어요
Canvas 이미지의 RGBA 배열에서 고유 색상을 추출하는 작업을 웹 워커로 분리했습니다. 다중 워커로 작업을 나눠 메인 스레드 블로킹과 UI 대기시간을 줄였습니다.

MongoDB 5.0의 Time Series Collection 구조와 생성·조회 방식을 설명했습니다. 메타데이터 기반 저장과 일괄 쓰기로 공간 및 조회 성능을 개선합니다.


FrontEnd 성능 측정 항목과 Lighthouse 등 분석 도구를 비교했습니다. Docker 기반 sitespeed.io·Grafana 대시보드 구성 절차를 안내합니다.
카카오웹툰은 GPU 가속과 lazy load로 복잡한 웹 인터랙션의 렌더링 비용을 줄였습니다. 스크롤 이벤트 대신 IntersectionObserver를 활용해 안정적인 프레임 성능을 확인했습니다.
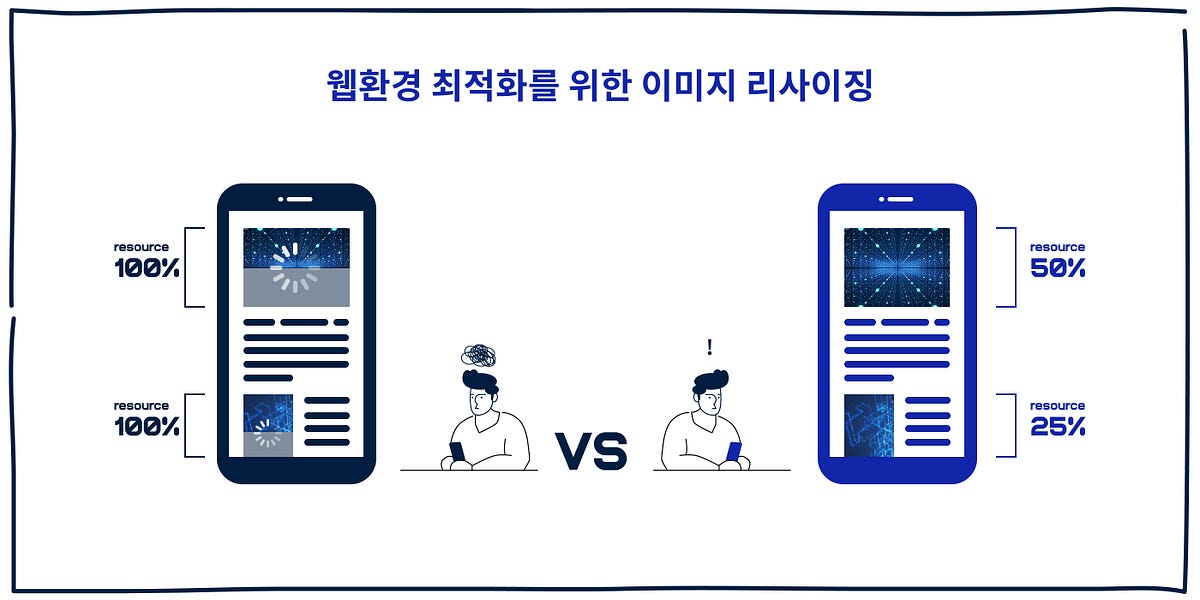
반응형 이미지의 srcSet·sizes 속성으로 기기와 레이아웃에 맞는 해상도를 제공합니다.\n압축과 리사이징을 결합해 리소스 용량과 웹 성능을 개선했습니다.

주소 기반 상품 노출과 기술부채 해소를 위해 카트를 4세대에 걸쳐 개선했습니다. 다중 세션 경합의 데드락은 아이템 공유형 Multi Cart로 완화했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

Artillery와 Linux perf Flamegraph로 Node.js 이미지 생성 서버의 병목을 분석했습니다.\n불필요한 이미지 리사이징을 제거해 처리량을 10 RPS에서 70 RPS로 개선했습니다.


TensorFlow 기반 N-gram 마스킹 위치 계산 병목을 C++ Custom Op으로 교체했습니다. 문장당 처리 시간을 4.697ms에서 17.147μs로 줄이며 약 250배 성능을 개선했습니다.

PostgreSQL MVCC에서 발생하는 dead tuple과 Autovacuum의 동작 기준을 설명했습니다. 테이블별 임계값·비용 설정과 모니터링으로 Data Bloat를 줄이는 방법을 제시합니다.


화해 백엔드 개발자의 역할과 성능·안정성 개선 노력을 소개했습니다. 소통, 코드 리뷰, 회고 중심의 개발 문화를 공유했습니다.


PostgreSQL의 pg_trgm 기반 GIN 인덱스로 환자 정보 부분 일치 검색을 개선했습니다. 100만 건 환경에서 `%LIKE%` 검색은 약 9~10배 빨라졌습니다.
VSMS 배포 전 성능 테스트에서 재고 갱신 순서로 인한 DB 데드락과 I/O 병목을 발견했습니다.\n상품 정렬과 로그 MongoDB 분리로 목표 1,200 TPS를 넘어 1,500 TPS 이상을 유지했습니다.
가상 재고 관리 시스템의 성능 테스트에서 DB 데드락과 I/O 병목을 발견해 개선했습니다. 잠금 순서 정렬, commit 축소, MongoDB 로그 분리로 목표 TPS를 넘겼습니다.
React의 컴포넌트, JSX, props, state로 선언형 UI를 구성하는 방식을 설명했습니다.\n재조정·얕은 비교·Hook을 통한 렌더링 최적화와 상태 로직 재사용을 다뤘습니다.